faucet-stream и магия Webhook-интеграций
В мире данных мы привыкли к pull-моделям: регулярно опрашивать API, вычитывать базы данных или забирать файлы. Но современные SaaS-сервисы всё чаще используют Webhooks — механизм, при котором событие само «толкается» (push) в ваш эндпоинт.
`faucet-stream` — это декларативный ETL-инструмент на Rust, который идеально подходит для обработки таких событий. Он настраивается через простой YAML-файл и позволяет за пару минут создать надежный конвейер от HTTP-запроса до современного формата хранения данных, например Apache Iceberg.
🌐 Где применим кейс с Webhook?
Webhook-источник в `faucet` — это универсальный «швейцарский нож». Вам не нужно писать код для интеграции с десятками сервисов, если они умеют отправлять HTTP-запросы:
- Jira / GitLab / GitHub: Ловить события создания, изменения или закрытия задач (issues) и пулл-реквестов для построения аналитики по продуктивности команд.
- Stripe / ЮKassa: Принимать уведомления об успешных платежах или подписках в реальном времени.
- CRM-системы (HubSpot, amoCRM): Ловить изменения статусов сделок.
- IoT-устройства: Отправлять телеметрию при наступлении определенных событий (например, срабатывании датчика).
Вы просто настраиваете в Jira Webhook на URL вашего `faucet`, и все изменения задач автоматически превращаются в строки в вашей Iceberg-таблице без единой строчки кода на Python или Java.
⚠️ Ограничения Webhook-подхода
Несмотря на удобство, важно понимать природу Webhooks:
- Доставка «At-most-once» (в лучшем случае): Отправитель (например, Jira) отправляет запрос и ждет ответа `200 OK`. Если ваш сервер временно недоступен (упал, перезагружается), событие будет потеряно навсегда. Webhooks не гарантируют доставку.
- Отсутствие идемпотентности: Отправитель может отправить одно и то же событие дважды (сетевые сбои). `faucet` запишет оба события (append-only), поэтому вам нужно самостоятельно чистить дубликаты на этапе аналитики.
- Зависимость от отправителя: Если Jira не имеет встроенного механизма повторных попыток (retry) при ошибках, вам придется самостоятельно обеспечивать высокую доступность эндпоинта `faucet`.
Для критически важных данных лучше использовать очереди (Kafka) или CDC (Debezium), но для аналитики, логов и некритичных бизнес-событий Webhook + `faucet` — это самое быстрое и дешевое решение.
🛠️ Пошаговая инструкция: Webhook → Iceberg → Trino
В этой инструкции мы развернем современный Lakehouse-стек:
- Silo (S3-совместимое хранилище с поддержкой STS).
- Lakekeeper (REST-каталог Iceberg).
- Trino (движок запросов).
- faucet-stream (приемщик вебхуков).
*(Стек запускается через Podman на macOS).*
📂 Шаг 1: Подготовка файлов
Создайте рабочую директорию и положите в нее три файла.
1. `docker-compose.yaml` (Только инфраструктура):
services:
  silo:
    image: pgsty/silo:RELEASE.2026-09-03T13-18-01Z
    command: server /data --console-address ":9001"
    environment:
      MINIO_ROOT_USER: silo-root-user
      MINIO_ROOT_PASSWORD: silo-root-password
    healthcheck:
      test: ["CMD", "mc", "ready", "local"]
      interval: 2s
      timeout: 10s
      retries: 2
      start_period: 15s
    ports:
      - "9000:9000"
      - "9001:9001"
    networks:
      - iceberg_net

  create-bucket:
    image: pgsty/silo:RELEASE.2026-09-03T13-18-01Z
    depends_on:
      silo:
        condition: service_healthy
    entrypoint: /bin/sh
    command:
      - -c
      - |
        mc alias set local http://silo:9000 silo-root-user silo-root-password &&
        mc mb --ignore-existing local/examples
    networks:
      - iceberg_net

  db:
    image: postgres:17
    environment:
      - POSTGRES_PASSWORD=postgres
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U postgres -p 5432 -d postgres"]
      interval: 2s
      timeout: 10s
      retries: 2
      start_period: 10s
    networks:
      - iceberg_net

  migrate:
    image: quay.io/lakekeeper/catalog:latest-main
    pull_policy: always
    environment:
      - LAKEKEEPER__PG_ENCRYPTION_KEY=This-is-NOT-Secure!
      - LAKEKEEPER__PG_DATABASE_URL_READ=postgresql://postgres:postgres@db:5432/postgres
      - LAKEKEEPER__PG_DATABASE_URL_WRITE=postgresql://postgres:postgres@db:5432/postgres
      - RUST_LOG=info
    restart: "no"
    command: ["migrate"]
    depends_on:
      db:
        condition: service_healthy
    networks:
      - iceberg_net

  lakekeeper:
    image: quay.io/lakekeeper/catalog:latest-main
    pull_policy: always
    environment:
      - LAKEKEEPER__PG_ENCRYPTION_KEY=This-is-NOT-Secure!
      - LAKEKEEPER__PG_DATABASE_URL_READ=postgresql://postgres:postgres@db:5432/postgres
      - LAKEKEEPER__PG_DATABASE_URL_WRITE=postgresql://postgres:postgres@db:5432/postgres
      - RUST_LOG=info
    command: ["serve"]
    healthcheck:
      test: ["CMD", "/home/nonroot/lakekeeper", "healthcheck"]
      interval: 1s
      timeout: 10s
      retries: 3
      start_period: 3s
    depends_on:
      migrate:
        condition: service_completed_successfully
      db:
        condition: service_healthy
      silo:
        condition: service_healthy
      create-bucket:
        condition: service_completed_successfully
    ports:
      - "8181:8181"
    networks:
      - iceberg_net

networks:
  iceberg_net:
    driver: bridge
2. `create-default-warehouse.json` (Настройка каталога):
{
  "warehouse-name": "demo",
  "project-id": "00000000-0000-0000-0000-000000000000",
  "storage-profile": {
    "type": "s3",
    "bucket": "examples",
    "endpoint": "http://silo:9000",
    "region": "us-east-1",
    "path-style-access": true,
    "flavor": "s3-compat",
    "sts-enabled": true
  },
  "storage-credential": {
    "type": "s3",
    "credential-type": "access-key",
    "aws-access-key-id": "silo-root-user",
    "aws-secret-access-key": "silo-root-password"
  }
}
3. `pipeline.yaml` (Конфигурация `faucet` с Webhook):
version: 1
pipeline:
  source:
    type: webhook
    config:
      listen_addr: "0.0.0.0:8080"
      path: "/v1/events"
      auth_token: "123"
      max_payloads: 10
      timeout_secs: 3600

  sink:
    type: iceberg
    config:
      catalog:
        type: rest
        uri: "http://lakekeeper:8181/catalog"
        warehouse: "demo"
        properties:
          # Включаем использование временных ключей от Lakekeeper
          rest.vended-credentials-enabled: "true"
          io-impl: "org.apache.iceberg.aws.s3.S3FileIO"
          s3.endpoint: "http://silo:9000"
          s3.path-style-access: "true"
          s3.region: "us-east-1"
      namespace: ["demo"]
      table: "events"
      create_table: true
      write_mode: append
🚀 Шаг 2: Запуск и инициализация
Выполняйте команды строго по одной в терминале.
1. Поднимаем инфраструктуру:
podman-compose down -v
podman-compose up -d
sleep 10
*Убедитесь, что контейнер `faucet-stream_lakekeeper_1` имеет статус `healthy` (`podman ps`).*
2. Инициализируем Lakekeeper (Bootstrap и создание Warehouse):
# Bootstrap
podman run --rm --network faucet-stream_iceberg_net curlimages/curl \
  -X POST http://lakekeeper:8181/management/v1/bootstrap \
  -H "Content-Type: application/json" \
  --data '{"accept-terms-of-use": true}'

# Создание Warehouse
podman run --rm --network faucet-stream_iceberg_net \
  -v "$(pwd)/create-default-warehouse.json:/tmp/wh.json" \
  curlimages/curl \
  -X POST http://lakekeeper:8181/management/v1/warehouse \
  -H "Content-Type: application/json" --data @/tmp/wh.json
3. Запускаем Trino и настраиваем каталог:
# Запуск Trino
podman run -d --name trino --network faucet-stream_iceberg_net \
  -p 9999:8080 -e CATALOG_MANAGEMENT=dynamic trinodb/trino:476

# Ждем инициализации Trino (20 секунд)
echo "Waiting for Trino to start..."
sleep 20

# Создаем каталог lakekeeper в Trino
podman exec trino trino --execute "
CREATE CATALOG lakekeeper USING iceberg
WITH (
    \"iceberg.catalog.type\" = 'rest',
    \"iceberg.rest-catalog.uri\" = 'http://lakekeeper:8181/catalog',
    \"iceberg.rest-catalog.warehouse\" = 'demo',
    \"iceberg.rest-catalog.nested-namespace-enabled\" = 'true',
    \"iceberg.rest-catalog.vended-credentials-enabled\" = 'true',
    \"iceberg.unique-table-location\" = 'true',
    \"s3.region\" = 'us-east-1',
    \"fs.native-s3.enabled\" = 'true',
    \"s3.path-style-access\" = 'true',
    \"s3.endpoint\" = 'http://silo:9000'
);"
🎯 Шаг 3: Запуск faucet и отправка вебхука
1. В новом окне терминала запускаем `faucet`:
podman run --rm -it --network faucet-stream_iceberg_net \
  -p 8081:8080 -v "$(pwd)/pipeline.yaml:/app/pipeline.yaml" \
  ghcr.io/faucet-hq/faucet-stream:full run /app/pipeline.yaml
2. В третьем окне отправляем тестовый вебхук (имитируем событие из Jira):
curl -X POST http://127.0.0.1:8081/v1/events \
  -H "Authorization: Bearer 123" \
  -H "Content-Type: application/json" \
  -d '{"event_id": "evt-001", "user": "alice", "action": "login"}'
*(В логах `faucet` вы увидите `records_written=10` и `succeeded=1`).*
3. Проверяем результат в Trino:
podman exec trino trino --execute "SELECT * FROM lakekeeper.demo.events;"Вывод:
"evt-001","alice","login"
"evt-002","alice","login"
...
Готово! Вы только что превратили HTTP-события в структурированную Iceberg-таблицу. 🎉
💡 Дополнение 1: За пределами Webhook: faucet как ETL-платформа
Хотя в этой инструкции мы сфокусировались на кейсе с Webhook, важно понимать, что `faucet-stream` — это не просто приемщик HTTP-запросов, а полноценная ETL-платформа.
Помимо Webhook, он поддерживает десятки других паттернов интеграции: от классического чтения REST API (с пагинацией и инкрементальной загрузкой) и баз данных (включая CDC из PostgreSQL и MySQL) до потоковой передачи из Kafka и чтения файлов из S3. Webhook — это лишь один из самых простых и быстрых способов начать, который идеально ложится на интеграцию с Jira, Stripe, GitHub и другими SaaS-сервисами.
🐛 О решенном баге и версиях
В ходе настройки мы столкнулись с ошибкой `StorageFactory must be provided for RestCatalog`. На момент выхода версии `v1.15.1` коннектор Iceberg в `faucet` не умел передавать фабрику хранилища для REST-каталогов. Команда проекта оперативно отреагировала на баг-репорт, и исправление уже вошло в последующие релизы (в частности, в рамках PR #966).
Теперь интеграция с Lakekeeper и Silo работает из коробки. Актуальный и стабильный образ всегда можно найти в официальном реестре: ghcr.io/faucet-hq/faucet-stream.
🍏 Почему мы запускали Trino и Faucet вручную на macOS?
Если вы обратили внимание, в инструкции мы запускали инфраструктуру (Silo, Lakekeeper) через `podman-compose`, а `Trino` и `faucet` — отдельными командами `podman run`.
Это не архитектурное требование, а вынужденный обход специфичного бага `podman-compose` на macOS. На Mac этот инструмент часто пытается объединить все контейнеры в один «Pod» и некорректно обрабатывает сложные цепочки зависимостей (`depends_on: condition: service_healthy`). В результате вы получаете общую ошибку `starting some containers: internal libpod error`, за которой невозможно разглядеть реальные логи контейнера.
Ручной запуск через `podman run` с явным указанием сети (`--network faucet-stream_iceberg_net`) гарантирует, что контейнеры стартуют в правильном порядке, а вы всегда видите их реальные логи. На Linux-серверах или в Docker Desktop для Mac этот шаг можно смело делать через стандартный `docker-compose up -d`.
В итоге, объединив мощь `faucet-stream`, современный REST-каталог Lakekeeper и движок Trino, вы получили гибкий и масштабируемый Lakehouse. Теперь любые события из внешних систем могут напрямую попадать в вашу аналитику без единой строчки кода! 🚀 Но не все так просто и радужно, как может показаться 🌈🦄 ...
💡 Дополнение 2: Архитектура faucet-stream, Push vs Pull и будущее потоковой обработки
В завершение статьи важно заглянуть «под капот» `faucet-stream` и обсудить два фундаментальных подхода к интеграции данных: Push (Webhook) и Pull (REST API). Понимание этой разницы критически важно, так как от нее зависит надежность вашего будущего Lakehouse.
📤 Push-модель (Webhook) и её ограничения в faucet
В этой инструкции мы использовали `webhook` — это классическая Push-модель. Отправитель (например, Jira или Stripe) сам «толкает» событие на ваш сервер.
- Плюсы: Мгновенная реакция на событие, минимальная задержка, не нужно писать код для опроса.
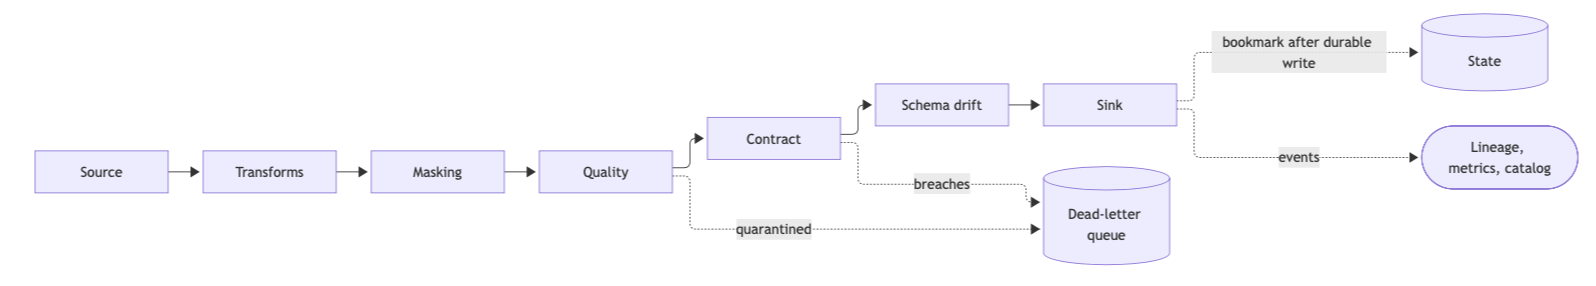
- Ограничения `faucet-stream`: Важно понимать, что источник `webhook` в `faucet` — это временный буфер, а не долгоживущий сервер. Сервер запускается, собирает POST-запросы в память (в течение `timeout_secs` или до `max_payloads`), а затем завершается, сбрасывая данные в Iceberg.
- Режим `serve`: Даже при запуске `faucet serve --triggers` триггер выступает лишь оркестратором. Он запускает пайплайн по событию, но само тело вебхука (`${trigger.body}`) не передается в пайплайн как готовый поток записей — его можно использовать только для параметризации источников внутри пайплайна.
- Риск потери: Если сервис перезагрузится или окно приема истечет в момент отправки, событие будет потеряно (доставка *at-most-once*). Установка огромного `timeout_secs` не решает проблему, а лишь откладывает ее, создавая риск переполнения памяти (OOM).
📥 Pull-модель (REST API): Надежность для Production
Альтернатива — Pull-модель. Вместо того чтобы ждать вебхук, `faucet` сам регулярно опрашивает API внешней системы (например, Jira) с помощью источника `rest`.
- Плюсы: Абсолютная надежность. Если `faucet` упал или был перезапущен, при следующем запуске он просто продолжит чтение с того места, где остановился (благодаря параметру `replication_method: Incremental`). Вы не потеряете ни одного события.
- Где использовать: Для критически важных бизнес-данных, аналитики и построения Lakehouse лучше выбирать именно Pull-модель, запуская пайплайн по расписанию (например, через `cron` или `faucet schedule` каждые 5-15 минут).
🌊 Сравнение с RisingWave: Batch/ETL против True Streaming
Учитывая слово `stream` в названии, многие ожидают от `faucet` поведения полноценной потоковой платформы, например, RisingWave.
- RisingWave — это потоковая база данных (True Streaming). Она выступает в роли постоянного получателя. Вы создаете таблицу с коннектором `webhook`, и все входящие HTTP-запросы немедленно попадают в нее и обрабатываются с низкой задержкой. Она держит состояние постоянно.
- faucet-stream — это, прежде всего, декларативный ETL-инструмент (Batch/ELT). Его парадигма — выполнение задачи (run) от начала до конца. Несмотря на название, на данный момент `faucet` не является долгоживущим стриминговым движком в том же смысле, что RisingWave или Kafka Streams. Его сила — в огромном количестве коннекторов, эффективной пакетной обработке и простоте YAML-конфигурации.
Взгляд в будущее: Слово «stream» в названии оставляет надежду, что в будущих версиях `faucet` может обзавестись более нативными примитивами для непрерывной потоковой обработки. Но на сегодняшний день, если вам нужен постоянный, вечно живой приемник вебхуков с гарантией сохранности каждого байта (что нетривиально при текущем состоянии документации 😁), — это задача для потоковых баз данных (RisingWave) или связки «сервис-приемник + очередь (Kafka/Redis)». Если же вам нужен мощный и гибкий инструмент для периодического перемещения данных (ETL) по расписанию или событию, `faucet-stream` с Pull-моделью — идеальный выбор.