Yuriy Gavrilov

Welcome to my personal place for love, peace and happiness 🤖

Части 3: Настройка HTTPS с самоподписными сертификатами для Traefik и Marimo

В предыдущей части мы настроили балансировку нагрузки через Traefik, но весь трафик ходил по HTTP — незашифрованным. В этой части мы добавим HTTPS с помощью самоподписных сертификатов. Это хороший способ подготовить инфраструктуру к продакшену, где вы сможете заменить их на сертификаты от Let’s Encrypt буквально одной строкой.

Часть 1: HashiCorp Nomad: развертывание интерактивного Python-приложения на macOS
Часть 2: Балансировка нагрузки и сервис-дискавери с Consul и Traefik для Marimo


Зачем нужен HTTPS

  • Шифрование: данные между браузером и сервером передаются в зашифрованном виде.
  • Подготовка к продакшену: архитектура с двумя точками входа (HTTP и HTTPS) и автоматическим редиректом — это стандартная схема.
  • Доверие к сертификатам: локально вы можете использовать самоподписные сертификаты, а в продакшене — Let’s Encrypt, не меняя структуру конфигурации.

Шаг 1: Генерация самоподписного сертификата

Для создания сертификата используем `openssl`, который уже есть в macOS. Важный момент: обязательно указываем Subject Alternative Name (SAN) с именем домена, иначе современные браузеры откажутся считать сертификат валидным.

mkdir -p ~/marimo-app/certs && cd ~/marimo-app/certs

openssl req -x509 -nodes -days 365 \
  -newkey rsa:2048 \
  -keyout marimo.localhost.key \
  -out marimo.localhost.crt \
  -subj "/CN=marimo.localhost" \
  -addext "subjectAltName=DNS:marimo.localhost"

В папке `certs` появятся два файла:

  • `marimo.localhost.key` — приватный ключ.
  • `marimo.localhost.crt` — сертификат.

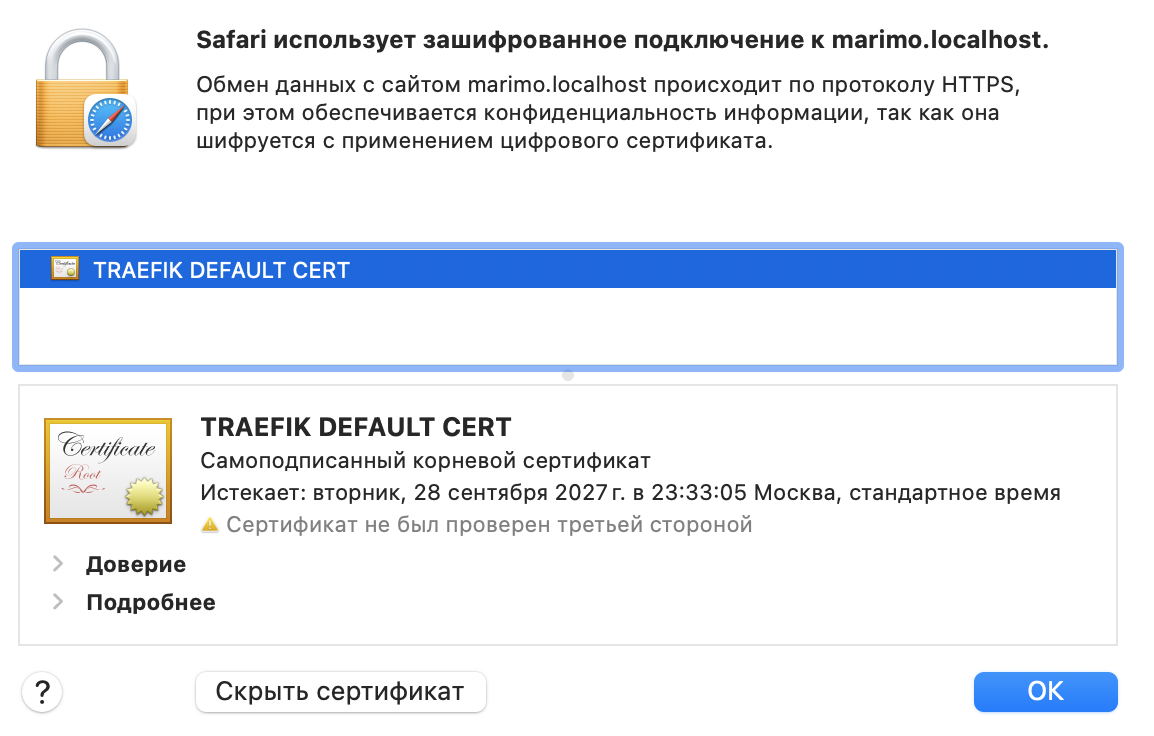
Что произойдёт при открытии сайта: браузер покажет предупреждение, что сертификат не является доверенным. Это ожидаемое поведение — вы можете принять исключение для домена `marimo.localhost`. В продакшене предупреждения не будет, так как сертификаты Let’s Encrypt автоматически доверенные.


Шаг 2: Обновление конфигурации Traefik

Traefik поддерживает разделение конфигурации на статическую (точки входа, провайдеры) и динамическую (маршруты, сертификаты). Мы создадим обе через блоки `template` в задании Nomad.

Статическая конфигурация

Добавим точку входа `websecure` на порту 8443 и настроим автоматический редирект с HTTP на HTTPS:

[entryPoints]
  [entryPoints.web]
    address = ":8080"
    [entryPoints.web.http.redirections.entryPoint]
      to = "websecure"
      scheme = "https"
      permanent = true

  [entryPoints.websecure]
    address = ":8443"

  [entryPoints.traefik]
    address = ":8081"

[api]
  dashboard = true
  insecure  = true

[providers.consulCatalog]
  prefix           = "traefik"
  exposedByDefault = false

  [providers.consulCatalog.endpoint]
    address = "127.0.0.1:8500"
    scheme  = "http"

[providers.file]
  filename = "${NOMAD_TASK_DIR}/dynamic.toml"
  watch    = true

Ключевые моменты:

  • `websecure` на порту `8443` — точка входа для HTTPS-трафика.
  • `[entryPoints.web.http.redirections.entryPoint]` — HTTP-запросы автоматически перенаправляются на HTTPS.
  • `[providers.file]` — подключает динамический провайдер, который читает наш файл с сертификатами.

Динамическая конфигурация

Здесь мы описываем сам сертификат:

[tls]
  [tls.stores]
    [tls.stores.default]
      [tls.stores.default.defaultCertificate]
        certFile = "/Users/yuriygavrilov/marimo-app/certs/marimo.localhost.crt"
        keyFile  = "/Users/yuriygavrilov/marimo-app/certs/marimo.localhost.key"

  [[tls.certificates]]
    certFile = "/Users/yuriygavrilov/marimo-app/certs/marimo.localhost.crt"
    keyFile  = "/Users/yuriygavrilov/marimo-app/certs/marimo.localhost.key"

Обратите внимание, что здесь используются абсолютные пути. Это работает, потому что мы запускаем Traefik через `raw_exec` — процесс работает прямо на хосте и имеет доступ ко всем файлам.


Шаг 3: Полное задание Traefik

Вот итоговый файл `traefik.nomad` с обеими конфигурациями:

job "traefik" {
  region      = "global"
  datacenters = ["dc1"]
  type        = "service"

  group "traefik" {
    count = 1

    network {
      port "http" {
        static = 8080
      }
      port "api" {
        static = 8081
      }
    }

    service {
      name = "traefik"
      check {
        name     = "alive"
        type     = "tcp"
        port     = "http"
        interval = "10s"
        timeout  = "2s"
      }
    }

    task "traefik" {
      driver = "raw_exec"

      # Статическая конфигурация Traefik
      template {
        data = <<EOF
[entryPoints]
  [entryPoints.web]
    address = ":8080"
    [entryPoints.web.http.redirections.entryPoint]
      to = "websecure"
      scheme = "https"
      permanent = true

  [entryPoints.websecure]
    address = ":8443"

  [entryPoints.traefik]
    address = ":8081"

[api]
  dashboard = true
  insecure  = true

[providers.consulCatalog]
  prefix           = "traefik"
  exposedByDefault = false

  [providers.consulCatalog.endpoint]
    address = "127.0.0.1:8500"
    scheme  = "http"

[providers.file]
  filename = "${NOMAD_TASK_DIR}/dynamic.toml"
  watch    = true
EOF
        destination = "local/traefik.toml"
      }

      # Динамическая конфигурация: сертификаты по абсолютному пути
      template {
        data = <<EOF
[tls]
  [tls.stores]
    [tls.stores.default]
      [tls.stores.default.defaultCertificate]
        certFile = "/Users/yuriygavrilov/marimo-app/certs/marimo.localhost.crt"
        keyFile  = "/Users/yuriygavrilov/marimo-app/certs/marimo.localhost.key"

  [[tls.certificates]]
    certFile = "/Users/yuriygavrilov/marimo-app/certs/marimo.localhost.crt"
    keyFile  = "/Users/yuriygavrilov/marimo-app/certs/marimo.localhost.key"
EOF
        destination = "local/dynamic.toml"
      }

      config {
        command = "/usr/local/bin/traefik"
        args = [
          "--configfile",
          "${NOMAD_TASK_DIR}/traefik.toml"
        ]
      }

      resources {
        cpu    = 100
        memory = 128
      }
    }
  }
}

Шаг 4: Обновление тегов Marimo

В задании `marimo-job.nomad` нужно переключить сервис на точку входа `websecure` и включить TLS:

service {
  name = "marimo-app"
  port = "http"
  tags = [
    "traefik.enable=true",
    "traefik.http.routers.marimo.rule=Host(`marimo.localhost`)",
    "traefik.http.routers.marimo.entrypoints=websecure",
    "traefik.http.routers.marimo.tls=true",
    "traefik.http.services.marimo-app.loadbalancer.sticky.cookie=true",
  ]
  check {
    type     = "http"
    path     = "/"
    interval = "2s"
    timeout  = "2s"
  }
}

Что изменилось:

  • `entrypoints=websecure` — трафик направляется на HTTPS-точку входа.
  • `tls=true` — включена TLS-терминация для этого маршрута.

Шаг 5: Запуск и проверка

Перезапустите оба задания:

nomad job stop traefik
nomad job run traefik.nomad
nomad job run marimo-job.nomad

Откройте в браузере:

https://marimo.localhost:8443
Браузер покажет предупреждение о недоверенном сертификате. Нажмите «Дополнительно» → «Перейти на marimo.localhost (небезопасно)» или добавьте сертификат в системный раздел доверенных сертов (в macOS это делается через «Связка ключей»).
Если вы попробуете открыть `http://marimo.localhost:8080`, Traefik автоматически перенаправит вас на HTTPS.


Возможные ошибки и их решения

Ошибка: `Unclosed configuration block`

Причина: незакрытые блоки `{ ... }` в HCL-файле.

Решение: внимательно проверьте, что все блоки `job`, `group`, `task`, `config`, `template` закрыты. В HCL отступы не важны, но фигурные скобки — критичны.

Ошибка: `Missing required argument: “command”` при `raw_exec`

Причина: конфигурация скопирована из задания для `docker` (с полями `image`, `volumes`, `network_mode`), но применён драйвер `raw_exec`.

Решение: для `raw_exec` используйте поля `command` и `args`. Файлы конфигурации создавайте через `template`.

Ошибка: `volume_mount` не поддерживается драйвером `raw_exec`

Причина: драйвер `raw_exec` работает напрямую с процессами хоста и не поддерживает монтирование томов.

Решение: используйте абсолютные пути к файлам (как мы сделали в динамической конфигурации). Или переходите на драйвер `docker`/`podman` — там `volume_mount` работает штатно.

Ошибка: `entryPoint “websecure” doesn’t exist`

Причина: имя точки входа в тегах сервиса не совпадает с именем в статической конфигурации Traefik.

Решение: убедитесь, что в конфиге есть блок `[entryPoints.websecure]`, а в тегах указано `traefik.http.routers.marimo.entrypoints=websecure`.


Итог

Мы добавили HTTPS в наш стек. Теперь архитектура выглядит так:

Пользователь (HTTPS)
     │
     ▼
  Traefik  ──►  Marimo 1 / 2 / 3
(8443)              │
     │              ▼
     └─────────► Consul
                    ▲
                    │
             Nomad Cluster
  • HTTP-трафик на порту 8080 автоматически перенаправляется на HTTPS.
  • HTTPS-трафик на порту 8443 расшифровывается Traefik и направляется на реплики Marimo.
  • Сертификаты хранятся на хосте и подключаются через абсолютные пути.

В продакшене достаточно заменить пути к сертификатам и указать Traefik получать их автоматически от Let’s Encrypt — структура конфигурации останется той же. Мы разберём это в следующей части.
Часть 2: Балансировка нагрузки и сервис-дискавери с Consul и Traefik для Marimo

В первой части мы развернули приложение Marimo через Nomad, используя драйвер `raw_exec` и динамические порты. Приложение работало, но у него был существенный недостаток: каждая реплика была доступна по отдельному порту, а пользователю приходилось вручную искать актуальный адрес. Кроме того, отсутствовала отказоустойчивость — при падении одной реплики трафик не перераспределялся.

Первая часть тут HashiCorp Nomad: развертывание интерактивного Python-приложения на macOS

В этой статье мы решим эти проблемы с помощью Consul (сервис-дискавери) и Traefik (балансировщик нагрузки). Мы также настроим липкие сессии (sticky sessions), которые критически важны для stateful-приложений, таких как Marimo.


Зачем нужны Consul и Traefik?

  • Consul — распределённый каталог сервисов. Он хранит информацию о работающих репликах, проверяет их здоровье и предоставляет DNS-интерфейс. Без него балансировщик не знал бы, куда направлять трафик.
  • Traefik — современный обратный прокси и балансировщик нагрузки. Он автоматически обнаруживает сервисы через Consul Catalog Provider и распределяет запросы между здоровыми репликами.
  • Nomad — оркестратор, который управляет всеми компонентами.

Итоговая архитектура:

Пользователь
     │
     ▼
  Traefik  ──►  Marimo 1 / 2 / 3
(балансировщик)      │
     │               ▼
     └──────────► Consul
                     ▲
                     │
              Nomad Cluster

Предварительные требования

Убедитесь, что у вас есть:

  1. Работающий Nomad в режиме разработки (`nomad agent -dev -bind=0.0.0.0`).
  2. Проект `~/marimo-app` с файлами `app.py`, `pyproject.toml`, `uv.lock` и виртуальным окружением.
  3. Установленный Consul.
  4. Установленный Traefik (мы будем запускать его через Nomad, но бинарник должен быть доступен).

Установка Consul

brew tap hashicorp/tap
brew install hashicorp/tap/consul

Установка Traefik

brew install traefik

Проверьте пути:

which consul   # /usr/local/bin/consul
which traefik  # /usr/local/bin/traefik

Шаг 1: Запуск Consul в режиме разработки

Откройте отдельный терминал и запустите Consul:

consul agent -dev -bind=0.0.0.0 -client=0.0.0.0

Consul будет доступен по адресу `http://127.0.0.1:8500`. Оставьте терминал открытым.

Важно: Consul должен быть запущен до того, как вы запустите Nomad с интеграцией с Consul, иначе сервисы не зарегистрируются.


Шаг 2: Обновление задания Marimo

Мы добавим в задание блок `service`, который зарегистрирует приложение в Consul и снабдит его тегами для Traefik. Также включим липкие сессии, чтобы запросы одного пользователя всегда попадали на одну и ту же реплику.

Создайте файл `marimo-job.nomad`:

job "marimo-app" {
  datacenters = ["dc1"]
  type = "service"

  group "app" {
    count = 3

    network {
      port "http" {}
    }

    service {
      name = "marimo-app"
      port = "http"
      tags = [
        "traefik.enable=true",
        "traefik.http.routers.marimo.rule=Host(`marimo.localhost`)",
        "traefik.http.routers.marimo.entrypoints=web",
        "traefik.http.services.marimo-app.loadbalancer.sticky.cookie=true",
      ]
      check {
        type     = "http"
        path     = "/"
        interval = "2s"
        timeout  = "2s"
      }
    }

    task "marimo" {
      driver = "raw_exec"

      config {
        command = "/Users/yuriygavrilov/marimo-app/.venv/bin/marimo"
        args = [
          "run", "app.py",
          "--headless",
          "--port", "${NOMAD_PORT_http}",
          "--host", "0.0.0.0"
        ]
        work_dir = "/Users/yuriygavrilov/marimo-app"
      }

      resources {
        cpu    = 500
        memory = 256
      }
    }
  }
}

Что изменилось:

  • `count = 3` — запускаем три реплики.
  • Блок `service` — регистрирует сервис в Consul.
  • Теги Traefik:
    • `traefik.enable=true` — разрешает Traefik обслуживать сервис.
    • `traefik.http.routers.marimo.rule=Host(\`marimo.localhost\`)` — правило маршрутизации по домену.
    • `traefik.http.routers.marimo.entrypoints=web` — точка входа (должна совпадать с именем в конфиге Traefik).
    • `traefik.http.services.marimo-app.loadbalancer.sticky.cookie=true` — включает липкие сессии на основе cookie.

Примечание про домен `.localhost`

В примере используется домен `marimo.localhost`. Добавлять его в `/etc/hosts` не нужно — имена, заканчивающиеся на `.localhost`, автоматически резолвятся в `127.0.0.1` согласно стандарту RFC 6761 (раздел 6.3) и RFC 6762. Это поведение поддерживается:

  • системным резолвером macOS (`mDNSResponder`),
  • всеми современными браузерами (Chrome, Safari, Firefox),
  • а также большинством инструментов командной строки (`curl`, `ping` и т.д.).

Именно поэтому `http://marimo.localhost:8080` будет работать «из коробки» без правки системных файлов.

Когда `/etc/hosts` всё-таки понадобится:

Если вы хотите использовать другое имя — например, `marimo.dev`, `marimo.internal` или реальный домен вроде `marimo.example.com`, — тогда запись нужна:

echo "127.0.0.1 marimo.dev" | sudo tee -a /etc/hosts

Для локальной разработки и тестирования домен `.localhost` — самый удобный вариант: он не требует никаких дополнительных настроек и работает одинаково на любой машине.


Шаг 3: Создание задания для Traefik

Traefik будет запущен через `raw_exec`. Конфигурационный файл создаётся динамически с помощью шаблона Nomad.

Создайте файл `traefik.nomad`:

job "traefik" {
  region      = "global"
  datacenters = ["dc1"]
  type        = "service"

  group "traefik" {
    count = 1

    network {
      port "http" {
        static = 8080
      }
      port "api" {
        static = 8081
      }
    }

    service {
      name = "traefik"
      check {
        name     = "alive"
        type     = "tcp"
        port     = "http"
        interval = "10s"
        timeout  = "2s"
      }
    }

    task "traefik" {
      driver = "raw_exec"

      # Создаём конфигурационный файл Traefik через шаблон
      template {
        data = <<EOF
[entryPoints]
  [entryPoints.web]
    address = ":8080"
  [entryPoints.traefik]
    address = ":8081"

[api]
  dashboard = true
  insecure  = true

# Включаем Consul Catalog Provider
[providers.consulCatalog]
  prefix           = "traefik"
  exposedByDefault = false

  [providers.consulCatalog.endpoint]
    address = "127.0.0.1:8500"
    scheme  = "http"
EOF
        destination = "local/traefik.toml"
      }

      config {
        command = "/usr/local/bin/traefik"
        args = [
          "--configfile",
          "${NOMAD_TASK_DIR}/traefik.toml"
        ]
      }

      resources {
        cpu    = 100
        memory = 128
      }
    }
  }
}

Ключевые моменты:

  • `driver = “raw_exec”` — запускаем бинарник напрямую.
  • `template` — создаёт файл `traefik.toml` в директории задачи.
  • `command` — полный путь к Traefik.
  • `args` — указываем путь к созданному конфигу через переменную `${NOMAD_TASK_DIR}`.
  • В конфиге Traefik точка входа называется `web` (порт 8080). Это имя должно совпадать с тегом `traefik.http.routers.marimo.entrypoints=web`.

Шаг 4: Запуск всех компонентов

Убедитесь, что Consul и Nomad запущены в отдельных терминалах.

Затем в терминале, где вы работаете с заданиями:

cd ~/marimo-app

# Запускаем приложение
nomad job run marimo-job.nomad

# Запускаем Traefik
nomad job run traefik.nomad

Проверьте статус:

nomad job status marimo-app
nomad job status traefik

Шаг 5: Проверка работы

  1. Consul: откройте `http://127.0.0.1:8500` и убедитесь, что сервис `marimo-app` зарегистрирован.
  1. Traefik Dashboard: откройте `http://127.0.0.1:8081/dashboard/`. В разделе HTTP Routers должен быть маршрут `marimo` со статусом Enabled. В HTTP Services — сервис `marimo-app` с тремя здоровыми репликами.
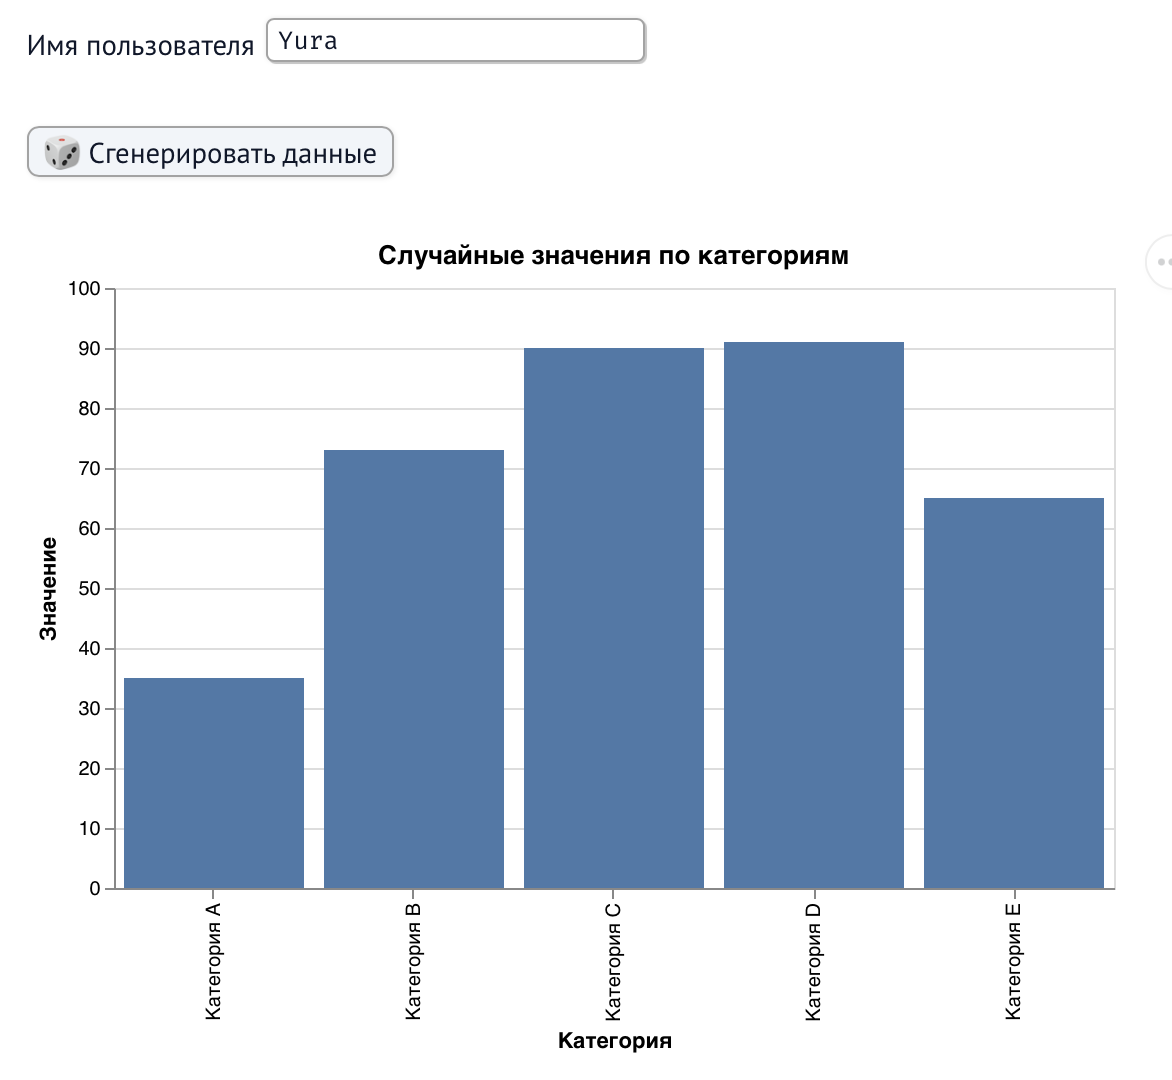
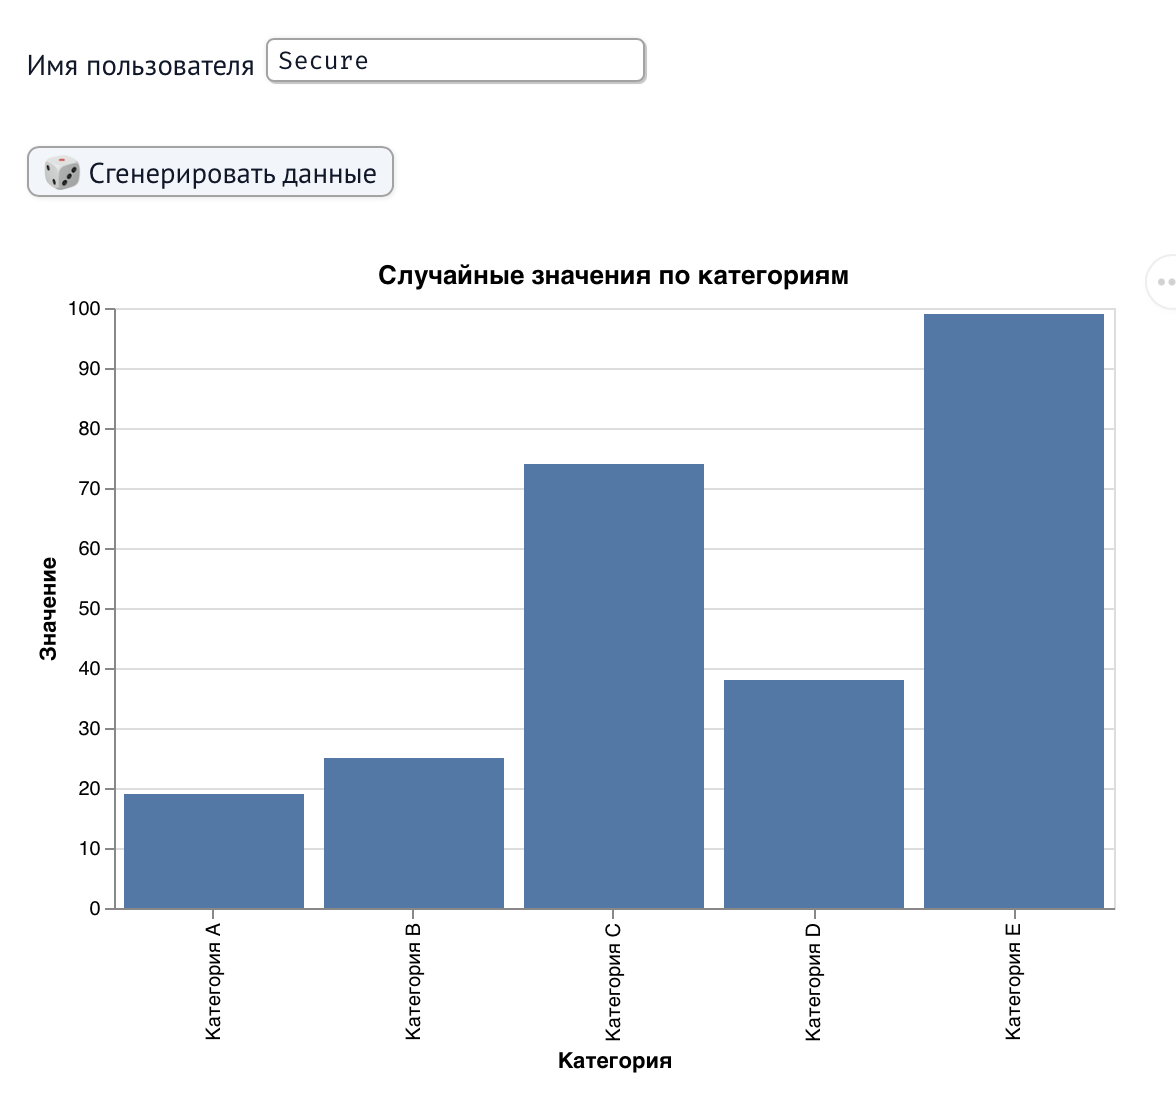
  1. Приложение: откройте `http://marimo.localhost:8080`. Вы должны увидеть интерфейс Marimo с полем ввода имени и диаграммой. Проверьте, что при нажатии кнопки данные обновляются, а ошибка `Invalid session id` не появляется.

Возможные ошибки и их решения

В процессе настройки мы столкнулись с несколькими типичными проблемами. Вот они и способы их устранения.

Ошибка 1: `EntryPoint doesn’t exist entryPointName=web`

Причина: в тегах сервиса указана точка входа `web`, а в конфигурации Traefik она называется иначе (например, `http`).

Решение: приведите имена к единому виду. В нашем случае мы переименовали точку входа в конфиге Traefik в `web`:

[entryPoints]
  [entryPoints.web]
    address = ":8080"

И в тегах указали `traefik.http.routers.marimo.entrypoints=web`.

Ошибка 2: `Invalid session id: s_bpy8u7`

Причина: отсутствие липких сессий. Marimo — stateful-приложение, оно хранит сессию на конкретной реплике. Если запросы распределяются случайно, браузер попадает на разные реплики, и сессия теряется.

Решение: добавьте тег `traefik.http.services.marimo-app.loadbalancer.sticky.cookie=true`. Traefik установит cookie и будет направлять все запросы от одного браузера на одну и ту же реплику.

Ошибка 3: `Missing required argument: “command”` при использовании `raw_exec`

Причина: конфигурация написана для драйвера `docker` (с полями `image`, `volumes`, `network_mode`), но применён `raw_exec`.

Решение: для `raw_exec` используйте `command` и `args`. Файлы конфигурации создавайте через `template`. Пример для Traefik приведён выше.

Ошибка 4: `raw_exec` отключён

Причина: в некоторых сборках Nomad драйвер `raw_exec` отключён по умолчанию.

Решение: добавьте в конфигурацию клиента Nomad (например, `/etc/nomad.d/nomad.hcl`):

plugin "raw_exec" {
  config {
    enabled = true
  }
}

и перезапустите агент Nomad, но в моем случае это не понадобилось.


Итог

Мы добавили к нашему приложению Marimo два важных компонента:

  • Consul — для сервис-дискавери и проверки здоровья.
  • Traefik — для балансировки нагрузки и единой точки входа.

Теперь приложение доступно по адресу `http://marimo.localhost:8080`, а трафик автоматически распределяется между тремя репликами. Благодаря липким сессиям пользователи не теряют состояние при работе с интерактивным интерфейсом.

Этот подход является основой для построения отказоустойчивых и масштабируемых систем. В следующих статьях мы рассмотрим настройку TLS/HTTPS, использование Vault для управления секретами и автоматическое масштабирование.

Поздравляю! Теперь ваше приложение готово к более серьёзным нагрузкам. 🚀

HashiCorp Nomad: развертывание интерактивного Python-приложения на macOS

В мире оркестрации контейнеров и приложений существует множество инструментов, но одним из самых гибких и простых в освоении является HashiCorp Nomad. Это оркестратор рабочих нагрузок, который позволяет развертывать как контейнеризированные, так и обычные приложения с использованием единого декларативного подхода.

В этой статье мы разберем, что такое Nomad, установим его на macOS, создадим простое интерактивное приложение на Marimo с полем ввода имени и генерацией случайных данных на столбчатой диаграмме, а затем развернем его с помощью Nomad, используя драйвер `raw_exec`. В конце обсудим ограничения такого подхода и путь к настоящему продакшену.


Что такое HashiCorp Nomad?

Nomad — это гибкий оркестратор рабочих нагрузок, который позволяет развертывать и управлять любыми контейнеризированными или устаревшими приложениями с помощью единого рабочего процесса.

Ключевые особенности

  • Универсальность: Nomad может запускать Docker-контейнеры, обычные приложения (без контейнеризации), микросервисы и пакетные задачи на одной инфраструктуре.
  • Простота: Nomad распространяется как единый бинарный файл, не требует внешних зависимостей для хранения или координации и автоматически обрабатывает сбои приложений, узлов и драйверов.
  • Масштабируемость: Nomad способен масштабироваться до 10 000+ узлов и имеет встроенную поддержку GPU-нагрузок.
  • Гибкость: Поддерживает различные типы задач: сервисы, пакетные задания и системные задачи. Работает на Linux, macOS и Windows.

Установка Nomad на macOS

Для установки Nomad на macOS удобнее всего использовать Homebrew. Выполните следующие команды в терминале:

# Добавляем репозиторий HashiCorp
brew tap hashicorp/tap

# Устанавливаем Nomad
brew install hashicorp/tap/nomad

После установки проверьте версию:

nomad version

Пример вывода:

Nomad v2.0.5
BuildDate 2026-08-12T18:22:41Z
Revision 5c8612bba6eb8e44cc3fc434125cb1b13463c309

Важно: На Intel Mac (x86_64) могут возникнуть проблемы с загрузкой бинарников из-за прекращения поддержки Apple. В этом случае рекомендуется использовать VPN для доступа к ресурсам HashiCorp. Если Nomad не устанавливается через Homebrew, можно собрать его из исходников или использовать MacPorts.


Запуск Nomad в режиме разработки

Для тестирования и разработки Nomad поддерживает режим `-dev`, который запускает одноузловой кластер на вашем компьютере:

nomad agent -dev -bind=0.0.0.0

Эта команда запустит Nomad, и веб-интерфейс будет доступен по адресу `http://127.0.0.1:4646`. Оставьте этот терминал открытым — это ваш “сервер” Nomad.


Создание Marimo-приложения

Установка `uv`

`uv` — это современный и быстрый менеджер пакетов для Python. Установите его:

curl -LsSf https://astral.sh/uv/install.sh | sh

Создание проекта

mkdir ~/marimo-app
cd ~/marimo-app
uv init
uv add marimo altair pandas numpy

Написание приложения

Создайте файл `app.py` со следующим содержимым. Приложение будет иметь поле для ввода имени, кнопку для генерации случайных значений и столбчатую диаграмму:

import marimo

__generated_with = "0.11.0"
app = marimo.App()


@app.cell
def _():
    import marimo as mo
    import altair as alt
    import pandas as pd
    import numpy as np
    return alt, mo, np, pd


@app.cell
def _(mo):
    # Поле для ввода имени
    name_input = mo.ui.text(
        placeholder="Введите ваше имя...",
        label="Имя пользователя"
    )
    name_input
    return (name_input,)


@app.cell
def _(mo, name_input):
    # Отображение приветствия
    if name_input.value:
        mo.md(f"## Привет, **{name_input.value}**! 👋")
    else:
        mo.md("## Введите имя выше")
    return


@app.cell
def _(mo):
    # Кнопка для генерации данных
    generate_button = mo.ui.button(
        label="🎲 Сгенерировать данные",
        value=0,
        on_click=lambda value: value + 1
    )
    generate_button
    return (generate_button,)


@app.cell
def _(alt, generate_button, mo, np, pd):
    # Генерация случайных данных при нажатии кнопки
    np.random.seed(generate_button.value)
    categories = ["Категория A", "Категория B", "Категория C", "Категория D", "Категория E"]
    values = np.random.randint(10, 100, size=5)
    
    df = pd.DataFrame({
        "Категория": categories,
        "Значение": values
    })
    
    chart = alt.Chart(df).mark_bar().encode(
        x=alt.X("Категория", sort=None),
        y="Значение",
        color=alt.value("#4C78A8")
    ).properties(
        title="Случайные значения по категориям",
        width=500,
        height=300
    )
    
    mo.ui.altair_chart(chart)
    return (chart,)


if __name__ == "__main__":
    app.run()

Проверка локально

Запустите приложение в режиме редактирования:

uv run marimo run app.py

Убедитесь, что приложение работает: введите имя, нажмите кнопку — диаграмма должна обновиться. Закройте сервер (`Ctrl+C`).


Создание задания для Nomad

Создайте файл `marimo-job.nomad` в папке проекта:

job "marimo-app" {
  datacenters = ["dc1"]
  type = "service"

  group "app" {
    count = 2

    network {
      port "http" {}
    }

    task "marimo" {
      driver = "raw_exec"

      config {
        command = "/Users/yuriygavrilov/marimo-app/.venv/bin/marimo"
        args = [
          "run", "app.py",
          "--headless",
          "--port", "${NOMAD_PORT_http}",
          "--host", "0.0.0.0"
        ]
        work_dir = "/Users/yuriygavrilov/marimo-app"
      }

      resources {
        cpu    = 500
        memory = 256
      }
    }
  }
}

Пояснения:

  • `driver = “raw_exec”` — запускает процесс напрямую на хосте без изоляции.
  • `count = 2` — запускаем две реплики приложения. Nomad автоматически распределит их по узлам (в нашем случае — по одному узлу, но на разных портах).
  • `port “http” {}` — динамический порт. Nomad резервирует случайный свободный порт для каждой аллокации. Такой подход избавляет от конфликтов портов при запуске нескольких реплик.
  • `command` — полный путь к исполняемому файлу `marimo` в виртуальном окружении.
  • `${NOMAD_PORT_http}` — Nomad автоматически подставляет динамически выделенный порт через переменную окружения `NOMAD_PORT_
  • `work_dir` — рабочая директория, где находится `app.py`.

Важно: замените `/Users/yuriygavrilov/` на реальный путь к вашей домашней директории.


Запуск задания

Убедитесь, что Nomad работает (в первом терминале). Во втором терминале выполните:

nomad job run marimo-job.nomad

Пример успешного вывода:

==> 2026-09-26T21:26:27+03:00: Monitoring evaluation "cba695bd"
    2026-09-26T21:26:27+03:00: Allocation "2327286c" created: node "7f836ccd", group "app"
==> 2026-09-26T21:26:27+03:00: Monitoring deployment "9ea4ff53"
  ✓ Deployment "9ea4ff53" successful
    
    Deployed
    Task Group  Desired  Placed  Healthy  Unhealthy  Progress Deadline
    app         1        1       1        0

Как узнать порт приложения

После запуска задания выполните:

nomad job status marimo-app

Вы увидите таблицу аллокаций с их ID. Для каждой аллокации выполните:

nomad alloc status <ID_аллокации>

В выводе найдите секцию `Allocation Addresses`:

Allocation Addresses:
Label  Dynamic  Address
*http  yes      127.0.0.1:20938

Откройте в браузере `http://127.0.0.1:20938` — ваше приложение работает.

Повторите команду для остальных аллокаций, чтобы получить порты всех реплик.


Ограничения текущего подхода

Мы успешно запустили приложение, но важно понимать, что это ещё не полноценное масштабированное решение. Вот почему:

1. Нет балансировщика нагрузки

У нас работают две реплики на разных портах (`20938`, `21001` и т.д.). Чтобы обратиться к приложению, пользователь должен знать конкретный порт каждой реплики. Это неудобно:

  • Нельзя дать пользователям один адрес, например `http://marimo.mycompany.com`.
  • Нет автоматического распределения трафика между репликами.
  • Нет отказоустойчивости: если одна реплика упадёт, клиент, знающий только её порт, потеряет доступ.

2. Нет сервис-дискавери

Nomad не регистрирует сервисы автоматически (для этого нужен Consul). Без сервис-дискавери балансировщик не сможет узнать, какие реплики сейчас работают.

3. Минимальная изоляция

Драйвер `raw_exec` запускает процессы прямо на хосте. В продакшене это небезопасно: приложение имеет доступ ко всей файловой системе и может влиять на систему.


Путь к продакшену: что нужно добавить

1. Балансировщик нагрузки (Traefik, NGINX, HAProxy)

Traefik — самый простой вариант для интеграции с Nomad. Он умеет:

  • Автоматически обнаруживать сервисы через Consul.
  • Распределять трафик между всеми здоровыми репликами.
  • Работать с TLS/HTTPS “из коробки”.
  • Иметь удобную панель управления.

Как это выглядит в задании: вы добавляете специальные теги в блок `service` вашего приложения, и Traefik сам настраивает маршрутизацию:

service {
  name = "marimo-app"
  port = "http"
  tags = [
    "traefik.enable=true",
    "traefik.http.routers.marimo.rule=Host(`marimo.localhost`)",
  ]
}

Затем запускаете Traefik как отдельную задачу в Nomad, и он становится единой точкой входа для всех пользователей.

2. Сервис-дискавери (Consul)

Consul — это распределённый каталог сервисов. Он:

  • Хранит информацию о том, какие реплики сейчас работают и на каких портах.
  • Предоставляет DNS-интерфейс: ваше приложение доступно как `marimo-app.service.consul`.
  • Позволяет балансировщику динамически обновлять список бэкендов.

3. Контейнеризация (Docker/Podman)

В продакшене используйте контейнерные драйверы вместо `raw_exec`:

  • Изоляция: приложение работает в своём окружении, не влияя на хост.
  • Воспроизводимость: одинаковое поведение на любой машине.
  • Безопасность: ограничения по ресурсам и правам доступа.

4. Полноценный кластер Nomad

В продакшене Nomad работает не как один процесс, а как кластер:

  • 3 серверных узла (минимум) — хранят состояние и принимают решения о планировании.
  • N клиентских узлов — выполняют задачи.
  • Интеграция с Vault для управления секретами.

Итоговая архитектура для продакшена

Пользователь
     │
     ▼
  Traefik  ──►  Marimo 1 / 2 / 3
(балансировщик)      │
                     ▼
                  Consul
                     ▲
                     │
              Nomad Cluster

Заключение

Мы рассмотрели базовый процесс развертывания Python-приложения с помощью HashiCorp Nomad:

  1. Установили Nomad через Homebrew.
  2. Запустили Nomad в режиме разработки.
  3. Создали Marimo-приложение с полем ввода имени и интерактивной диаграммой.
  4. Написали задание Nomad с драйвером `raw_exec` и динамическим портом.
  5. Запустили две реплики приложения и научились находить их порты.

Этот подход отлично работает для разработки и тестирования. Но для настоящего продакшена необходимо:

  • Добавить балансировщик нагрузки (Traefik, NGINX, HAProxy), чтобы пользователи обращались к одному адресу.
  • Внедрить сервис-дискавери (Consul), чтобы балансировщик знал о работающих репликах.
  • Использовать контейнерные драйверы (Docker, Podman) для изоляции.
  • Построить полноценный кластер Nomad с тремя серверными узлами.

Nomad — это мощный и гибкий инструмент, который подходит как для простых задач, так и для сложных распределённых систем. Его простота и универсальность делают его отличным выбором для разработчиков, которые хотят быстро развертывать приложения без излишней сложности Kubernetes.

Следующий логичный шаг — добавить Traefik и Consul, чтобы превратить наш прототип в отказоустойчивое и масштабируемое решение. Об этом — в следующих статьях.

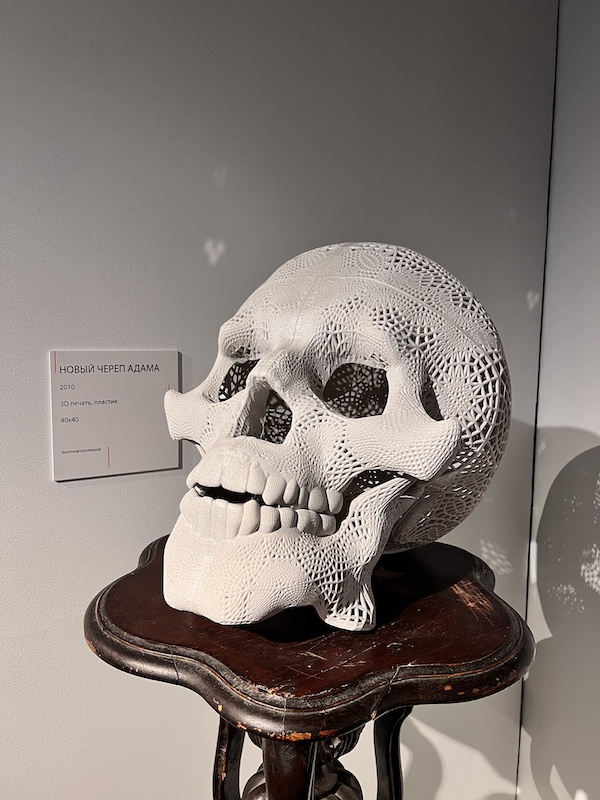
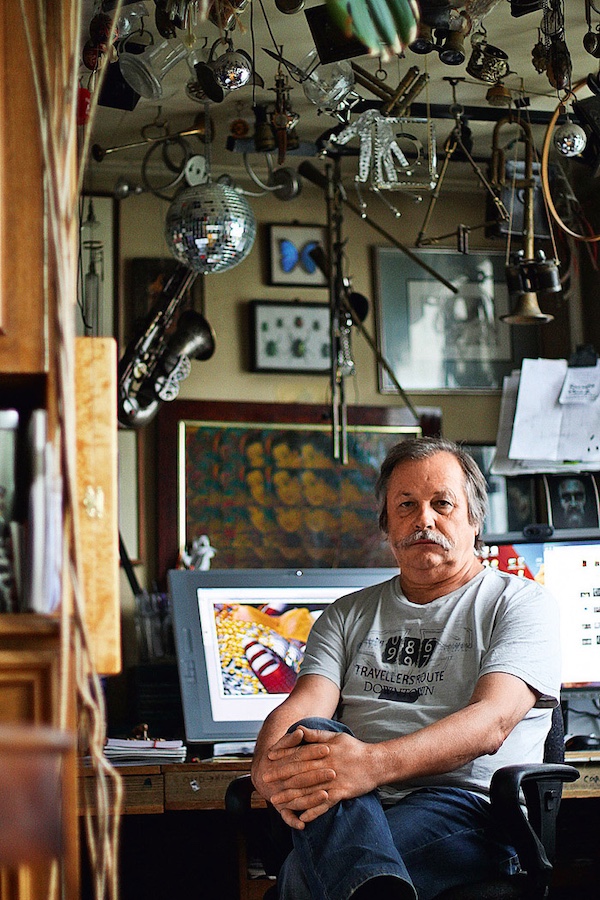
Мастерская новатора: цифровое искусство Константина Худякова

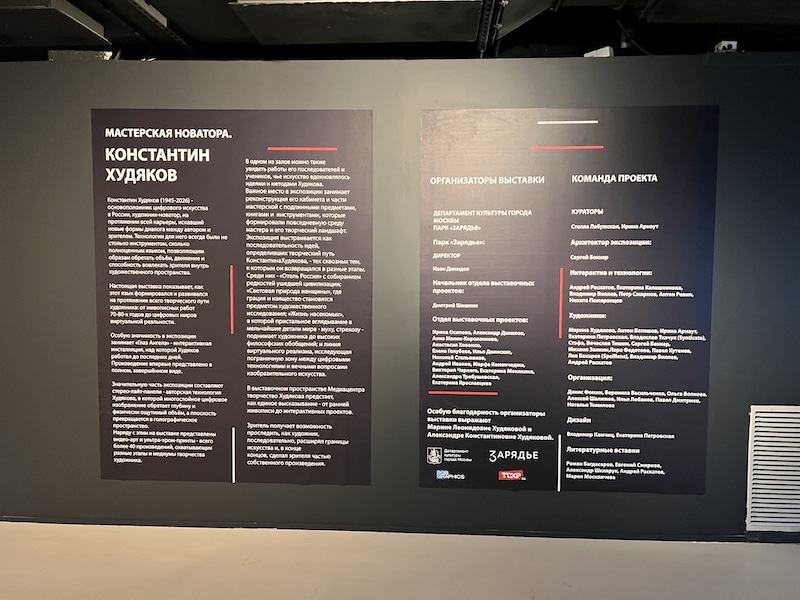
Вчера, 19 сентября 2026 года, мне посчастливилось побывать в парке «Зарядье» на выставке «Мастерская новатора. Константин Худяков». Это событие стало для меня не просто очередным культурным выходом, а настоящим погружением в мир, где технологии и искусство сплетаются в единое целое. Выставка, посвященная памяти художника-визионера и одного из основоположников цифрового искусства в России, открылась 18 сентября и продлится до 8 ноября.

Спасибо организаторам 🙏🤗🤝

🖼️ Два образа, которые не отпускают

Среди почти полусотни представленных работ меня особенно поразили два произведения, которые, на первый взгляд, совершенно разные, но в моем восприятии оказались неразрывно связаны.

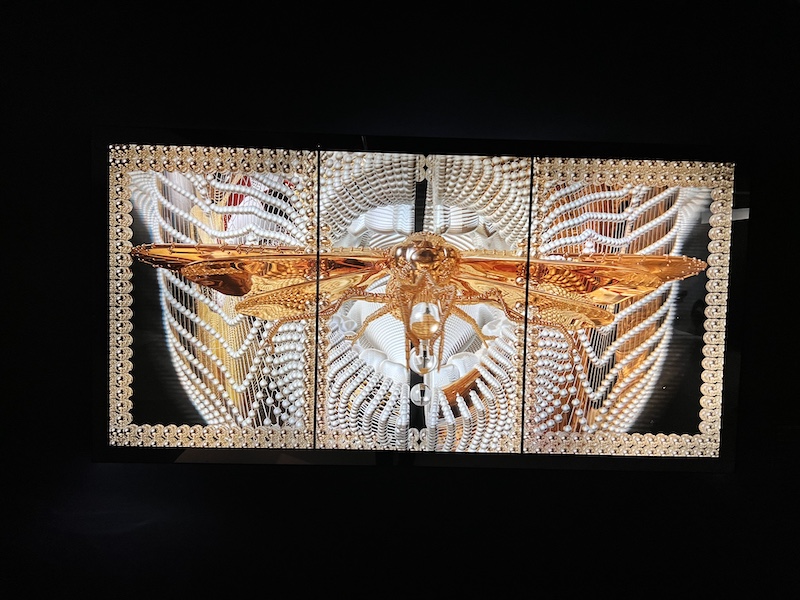
«Стрекоза» — это не просто изображение насекомого, а целая вселенная, застывшая в хрупком панцире. Меня восхитила филигранная точность, с которой прорисована каждая деталь: переливы крыльев, грани фасеточных глаз, тончайшие прожилки. Казалось, что это не цифровая печать, а живой организм, пойманный в момент полета. В этой работе чувствуется рука архитектора, который видит мир в структурах и формах, но при этом наполняет их невероятной эмоциональностью.

Стерео-лайт-панель — это уникальное технологичное произведение цифрового искусства, созданное российским художником Константином Худяковым. Эта техника соединяет многоракурсную стереофотографию, компьютерную графику и внутреннюю светодиодную подсветку, создавая эффект живого объемного изображения без очков.

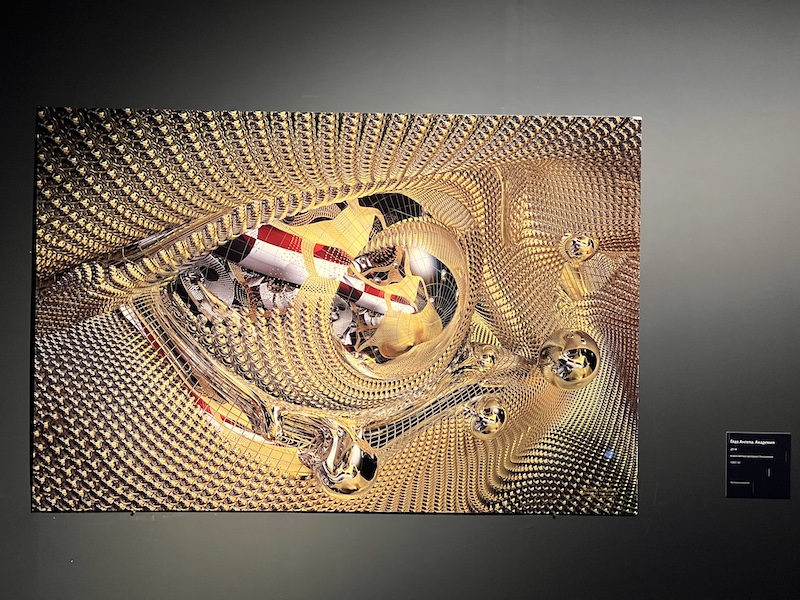
«Глаз ангела» — работа, которая завораживает с первого взгляда. Это не просто глаз, а портал в иную реальность, где каждый отраженный луч, каждая частица света рассказывают свою историю. Меня поразила глубина и многослойность этого образа и детализация. Когда смотришь на него, кажется, что видишь не только саму картину, но и время, в которое она была создана, и мысли автора, вложенные в нее. Эти две работы понравились мне одинаково сильно, и я до сих пор нахожусь под их впечатлением.

🧬 Код цифрового искусства

Размышляя над увиденным, я осознал одну очень существенную черту цифрового искусства, которая отличает его от традиционного. С одной стороны, цифровая картина — это просто изображение, которое можно скопировать и размножить. Но с другой — в ней всегда скрыты тысячи слоев, созданных ее творцом.

Каждый слой — это не просто технический элемент. Это образ жизни художника, его мировоззрение, технологии, которые были доступны на момент создания, и само время, которое диктовало свои условия. Раскрывая эти слои один за другим, начинаешь видеть, как автор превосходил свое время, заглядывая в будущее и предугадывая то, что станет доступно лишь десятилетия спустя. Худяков начал работать с цифровыми технологиями еще в конце 1990-х, когда многие даже не представляли, что компьютер может быть инструментом искусства. Его авторская техника «искусства высокого разрешения» позволяла создавать графику, которая по качеству и глубине не уступала живописи.

В конце концов, все эти слои сливаются воедино, в одну работу. Это как небольшой генетический код произведения. В нем одновременно есть что-то живое, пульсирующее, и частица самого автора — его душа, мастерство и интеллект.

Именно это делает работы Худякова такими уникальными. Они не просто фиксируют реальность, а создают новую, наполненную смыслом и предчувствием. Работы немного заводят вперед своей детальностью, но при этом не вызывают ощущения оторванности от реальности. Наоборот, они доносят до зрителя то, что происходит здесь и сейчас, теми словами и образами, которые мы понимаем, находясь в текущем времени. Неживые работы обычно уводят далеко без причин, и связь с настоящим теряется. В этом уникальность и сложность цифровых произведений, а мастерство автора заключается в умении донести свой смысл и свой взгляд. Авторы, опираясь на события, доступные им, в сочетании с мастерством, стараются донести то, что видят, чувствуют или хотят сказать.

🌱 Ученики и последователи

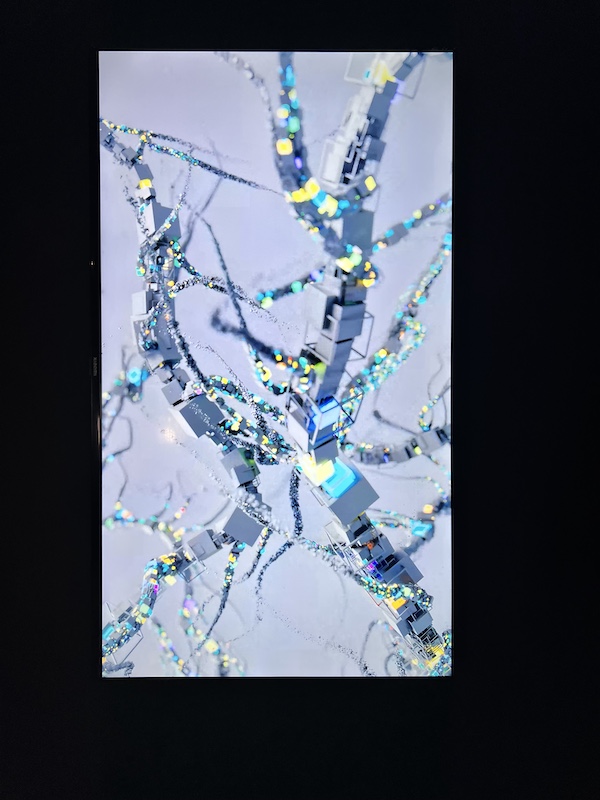
На выставке также были представлены работы учеников и последователей Худякова. Мое внимание привлекли проекты, созданные командой студии Synticate. Эта арт-группа, основанная Владиславом Ткачуком и Романом Цукановым, занимается созданием цифровых форм жизни и исследованием будущего симбиоза природы и технологий. Их концепция «экофутуризма» очень близка идеям Худякова о синтезе искусства и науки.

Особенно интересной мне показалась работа из серии «Киберорганика». В этой работе чувствуется тот же подход, что и у Худякова: синтез природы и технологий, создание новой формы жизни на стыке реального и цифрового. Synticate интегрируют компьютерную графику в реальные съемки, что позволяет им рассказывать истории о будущем, не отрываясь от настоящего.

🤝 Коллективное творчество

Отдельно хочется сказать о том, как Худяков работал над своими масштабными проектами. Художник создавал цифровые портреты, используя фотографии реальных людей, а затем объединял их в единое многоликое произведение. Например, в проекте «Биохакинг» приняли участие 250 человек — Худяков сделал более 150 снимков лица каждого, чтобы затем создать собирательный образ. Этот подход — использование коллективного опыта и множества человеческих лиц для создания одного образа — как нельзя лучше отражает его философию: искусство создается не в вакууме, а из живого опыта многих людей и становятся их кодом.

💎 Заключение

Посещение «Мастерской новатора» стало для меня не просто знакомством с творчеством Константина Худякова, но и глубоким размышлением о природе цифрового искусства. Работы, увиденные вчера, — это не просто картинки. Это многослойные коды, в которых зашифрована жизнь их создателя, его время и его взгляд в будущее.

И, возможно, именно в этом и заключается главная сила цифрового искусства — в его способности быть одновременно и зеркалом настоящего, и окном в будущее, и генетическим кодом заложенным автором.

Hugr: Data Mesh-платформа и GraphQL-бэкенд на базе DuckDB

1. Что такое Hugr и зачем он нужен

Hugr — это open-source платформа класса Data Mesh и высокопроизводительный GraphQL-бэкенд, построенный поверх аналитического движка DuckDB. Проект развивается командой hugr-lab под руководством Владимира Грибанова и распространяется под лицензией MIT.

Назначение — решить конкретную инженерную боль: данные в организации разбросаны по десяткам систем (PostgreSQL, SQL Server, S3, REST API, Kafka, Redis), и каждая команда строит собственный слой доступа. Классические ETL-пайплайны и дублирование данных в единое хранилище дают задержку актуальности, удваивают инфраструктуру и создают узкое горлышко на дата-инженерах.

Hugr предлагает иную модель: данные остаются на месте, а поверх них выстраивается единый GraphQL-слой, который компилирует декларативные схемы в исполняемые запросы к каждому источнику. Для аналитика — один интерфейс вместо десятков коннекторов. Для разработчика — типизированный GraphQL API без ручного CRUD. Для дата-инженера — декларативное описание схемы через SDL-директивы вместо поддержки ETL.

Ключевые характеристики:

Параметр Значение
Лицензия MIT
Ядро DuckDB (in-process, колоночный, OLAP)
Интерфейс GraphQL (queries, mutations, subscriptions)
Язык реализации Go
Репозитории `hugr-lab/hugr`, `hugr-lab/query-engine`
Развёртывание Docker, Kubernetes, embedded в Go-сервисы

2. Архитектура: почему именно такая

2.1. Мотивация

Традиционный подход «единое хранилище» (Data Warehouse / Lakehouse) предполагает перемещение данных в одну точку. Это создаёт три проблемы:

  1. Задержка актуальности — данные в хранилище отстают от источника.
  2. Дублирование и стоимость — копирование петабайтов дорого и медленно.
  3. Схема-каплинг — потребители привязаны к физической структуре хранилища.

Data Mesh инвертирует модель: каждый домен владеет своими данными и публикует их как продукт, а платформа обеспечивает федеративный доступ. Hugr — инфраструктура этого доступа.

2.2. Компоненты

┌────────────────────────────────────────────────┐
│                  Клиенты                       │
│   Web · BI · Python · MCP/AI                   │
└───────────────────────┬────────────────────────┘
                        │ GraphQL / IPC / REST
┌───────────────────────▼────────────────────────┐
│              Hugr Server (Go)                  │
│  ┌──────────┐ ┌──────────┐ ┌────────────────┐  │
│  │ GraphQL  │ │ Schema   │ │ Access Control │  │
│  │ API+Subs │ │ Compiler │ │ OAuth2 / RBAC  │  │
│  └──────────┘ └──────────┘ └────────────────┘  │
│  ┌──────────────────────────────────────────┐  │
│  │     DuckDB Analytical Engine (Go)        │  │
│  │  In-process · Колоночный · Vectorized    │  │
│  └──────────────────────────────────────────┘  │
│  ┌──────────┐ ┌──────────┐ ┌────────────────┐  │
│  │  Cache   │ │  CoreDB  │ │ IPC Protocol   │  │
│  │Mem+Redis │ │ metadata │ │  (Arrow)       │  │
│  └──────────┘ └──────────┘ └────────────────┘  │
└──┬──────────┬──────────┬───────────┬───────────┘
   │          │          │           │
┌──▼───┐  ┌───▼────┐ ┌───▼────┐ ┌────▼──────┐
│ PG / │  │SQL Srv │ │DuckLake│ │ REST API  │
│MySQL │  │Azure   │ │Iceberg │ │Arrow Fl.  │
│Parq. │  │        │ │S3/CSV  │ │ Redis KV  │
└──────┘  └────────┘ └────────┘ └───────────┘

DuckDB как ядро — in-process колоночная СУБД для OLAP. Не требует отдельного процесса и сетевого порта, работает с десятками форматов (Parquet, CSV, JSON, GeoParquet, Delta Lake), обеспечивает векторизованное исполнение. Для Hugr это нулевая сетевая задержка между движком и логикой и возможность кросс-источниковых JOIN’ов в памяти.

CoreDB хранит метаданные: источники, каталоги схем, роли, политики доступа. Может быть DuckDB-файлом или PostgreSQL (обязателен для кластера).

Компилятор схем преобразует GraphQL SDL с директивами (`@table`, `@view`, `@function`, `@field_references`, `@join`, `@module`) в логическую модель, из которой генерируются типы, фильтры, агрегации, мутации и sub-query поля для связей.


3. Источники данных: единая точка входа

3.1. Поддерживаемые типы

Категория Источники Особенности
Реляционные PostgreSQL (PostGIS, TimescaleDB, pgvector), MySQL, SQL Server / Azure SQL Pushdown фильтров, сортировки, агрегаций и JOIN’ов
Озёра данных DuckLake, Apache Iceberg (REST, Glue, S3 Tables) Time-travel, snapshot-based DDL/DML
Файлы Parquet, Delta Lake, CSV, JSON, GeoParquet, Shapefiles Через DuckDB, поддержка S3 и Hive-партиционирования
Сервисы REST API, Arrow Flight gRPC, GraphQL (в разработке) Basic, ApiKey, OAuth2
AI/ML Embeddings, LLM (OpenAI, Anthropic, Gemini) Единый tool calling, streaming
Key-Value Redis Pub/Sub, keyspace events, TTL
Расширения Extension-источник, Hugr Apps Кросс-источниковые представления, кастомные функции

3.2. Декларативная регистрация

Источник описывается мутацией `insert_data_sources`, после чего его схема компилируется и попадает в общее GraphQL-дерево. Адаптеры и коннекторы писать не нужно.

mutation {
  core {
    insert_data_sources(data: {
      name: "my_llm"
      type: "llm-openai"
      prefix: "my_llm"
      path: "http://localhost:1234/v1/chat/completions?model=gemma-4&timeout=120s"
    }) { name }
  }
}

Новый источник появляется в API за одну мутацию, без пересборки и перезапуска.


4. GraphQL как универсальный слой доступа

4.1. Автогенерация из схемы

Для каждого табличного объекта компилятор создаёт:

  • запросы с `filter`, `order_by`, `distinct_on`, `limit`, `offset`;
  • запрос по первичному ключу (`object_name_by_pk`) и уникальным полям;
  • агрегации (`object_name_aggregation`) и корзинные агрегации (`object_name_bucket_aggregation`);
  • мутации `insert`, `update`, `delete` с типизированными входными структурами;
  • фильтровые типы с операторами `eq`, `in`, `gt`, `lt` и вложенными фильтрами по связям;
  • sub-query поля для связей (включая M2M), query-time JOIN’ы и пространственные JOIN’ы.

Дата-инженер описывает логическую модель — полный CRUD, агрегации и связи появляются автоматически.

4.2. Подписки

  • Streaming LLM completions — токены с событиями `content_delta`, `reasoning`, `tool_use`, `finish`, `error`.
  • Pub/Sub — подписка на каналы Redis.
  • Keyspace events — мониторинг изменений ключей по паттерну.

4.3. JQ-трансформации

Серверные JQ-преобразования: встроенный `jq()` в GraphQL, REST-эндпоинт `/jq-query`, доступ к переменным через `$var_name`, вложенные GraphQL-запросы из JQ через `queryHugr()`. Это постобработка без выгрузки в Python — группировка, фильтрация, реструктуризация на сервере.


5. AI-возможности: LLM и Embeddings

5.1. Модуль `core.models`

Функция Назначение
`embedding` / `embeddings` Векторные эмбеддинги (одиночный и батч)
`completion` Простая генерация текста
`chat_completion` Многооборотный диалог с tool calling
`model_sources` Список зарегистрированных моделей

Провайдеры: OpenAI (и совместимые: Ollama, LM Studio, vLLM, Mistral, Qwen, Azure OpenAI), Anthropic (Claude), Google Gemini. Различия форматов абстрагированы.

5.2. Tool Calling и Round-trip

Вызовы инструментов нормализованы. Для Gemini 2.5+ поддерживается `thought_signature` — обязательное поле при отправке результатов инструментов обратно модели. Пайплайн: запрос → `tool_calls` + `thought_signature` → исполнение инструмента → сообщение с `role: “tool”` → полная история в `chat_completion`.

5.3. Thinking Budget

Параметр `thinking_budget` управляет chain-of-thought: задаётся на уровне источника (максимум) и запроса (кап). Модель сначала выдаёт `reasoning`-события, затем `content_delta`.

5.4. MCP-интеграция

Поддержка Model Context Protocol позволяет AI-ассистентам (Claude, Cursor) исследовать схему, выполнять семантический поиск и генерировать/валидировать GraphQL-запросы. Основа для «vibe-аналитики»: LLM строит запросы на естественном языке, Hugr их исполняет.


6. Hugr Apps: расширяемость через Arrow Flight

6.1. Концепция

Hugr Apps — внешние Go-приложения, подключаемые через DuckDB Airport extension (Apache Arrow Flight gRPC). Публикуют в общую GraphQL-схему скалярные функции, таблицы, табличные функции и собственные источники данных (например, PostgreSQL с миграциями).

6.2. Жизненный цикл

Сценарий Обнаружение Восстановление Потеря данных
Graceful shutdown Немедленно N/A Нет
Краш приложения Heartbeat (~90 сек) Мгновенно при рестарте Нет
Рестарт Hugr Startup load LoadDataSource Нет
Обновление версии Изменение пути Мгновенно (миграция) Нет

Heartbeat: интервал 30 сек, таймаут 10 сек, 3 неудачи → приостановка каталога. При восстановлении каталог перекомпилируется.

6.3. Практический смысл

Бизнес-логику (геокодирование, скоринг, расчёты) можно вынести в отдельный сервис и опубликовать как SQL/GraphQL-функции без изменения основного конвейера.


7. Production-readiness и работа под нагрузкой

7.1. Кластерный режим

  • CLUSTER_ROLE: `management` или `worker`.
  • Management-нода координирует синхронизацию схем, жизненный цикл источников и конфигурацию хранилищ.
  • Worker-ноды получают обновления через push (broadcast) и pull (polling).
  • PostgreSQL CoreDB обязателен — все ноды разделяют единую метабазу.

7.2. Кеширование

  1. In-memory — горячие данные на каждой ноде.
  2. Внешний кеш (Redis / Memcached) — разделяемый, инвалидация при мутациях.

Директива `@cache` управляет кешированием на уровне схемы.

7.3. Производительность

  • Нулевая сетевая задержка между логикой и движком.
  • Векторизованное колоночное исполнение.
  • Поддержка десятков форматов без конвертации.
  • Кросс-источниковые JOIN’ы в памяти.
  • Filter pushdown — условия `WHERE` передаются на сторону источника (особенно PostgreSQL).

7.4. Безопасность

OAuth2 / OpenID Connect, field-level и row-level security, ролевая модель с предопределёнными фильтрами, автозаполнение контекста пользователя/роли в мутациях.

7.5. Развёртывание

  • Docker: `docker run -d --name hugr -p 15000:15000 -v ./schemas:/schemas ghcr.io/hugr-lab/automigrate:latest`
  • Kubernetes: Helm-чарты в `hugr-lab/docker` (multi-node, load balancing, кеширование).
  • Embedded: Go-пакет `hugr-lab/query-engine`.

7.6. Ограничения

  • Планируются коннекторы к SQLite (через DuckDB) и ClickHouse.
  • GraphQL как источник данных — в разработке.
  • «Talk-to-data» (естественный язык) — анонсирован.

Для высоких нагрузок рекомендуется кластерный режим с PostgreSQL CoreDB и Redis-кешем.


8. Области применения и примеры

8.1. Бэкенд данных для приложений

Единый GraphQL-слой поверх существующих БД: быстрый запуск API, централизованная схема, контроль доступа.

{
  marketing {
    campaigns_aggregation_bucket {
      key { channel { name } }
      aggregations { payments { amount { sum } } }
    }
  }
}

8.2. Data Mesh-платформа

Каждый домен публикует свою схему как модуль. Федеративный доступ через единый API, децентрализованное владение.

8.3. Аналитика и MLOps

OLAP-запросы и пространственные агрегации через GraphQL, экспорт в Arrow IPC → Python (pandas, GeoDataFrame, Jupyter), JQ-трансформации на сервере, цикл Ingestion → Processing → ML → API Access.

8.4. Агентная аналитика (Vibe Analytics)

Через MCP-эндпоинт LLM-агент исследует схему, генерирует запросы, выполняет цепочки и строит JQ-преобразования. Пользователь задаёт вопрос на естественном языке — агент возвращает результат.

8.5. Реал-тайм дашборды

Подключение Grafana/Metabase к Hugr → данные обновляются на каждый запрос, без ETL-задержек, с комбинацией нескольких источников.

8.6. Геопространственные задачи

Нативные пространственные типы, кросс-источниковые spatial JOIN’ы, поддержка GeoParquet, GeoJSON, Shapefiles, агрегации по пространственным отношениям.


9. Итог

Hugr занимает нишу между «тяжёлыми» платформами данных (Databricks, Snowflake) и лёгкими GraphQL-обёртками над одной БД. Его ценность:

  • Декларативность — схема через SDL-директивы, полный CRUD генерируется автоматически.
  • Федеративность — данные не перемещаются, доступ на месте.
  • Производительность — DuckDB in-process даёт колоночную векторизацию без сетевых накладных расходов.
  • Расширяемость — Hugr Apps, Extension-источники, AI-модуль, Redis.
  • Открытость — MIT, Go-стек, Docker/K8s, embedded-режим.

Для команды, которая хочет дать аналитикам и приложениям единый доступ к разнородным данным без ETL-империи, Hugr — зрелый и прагматичный выбор с понятной траекторией масштабирования.


10. Что ещё: другие инструменты и события из рассылки DuckDB (сентябрь 2026)

Ежемесячная рассылка DuckDB #45 (16 сентября 2026) принесла несколько значимых новостей.

Крупные события

  • AWS приобретает DuckLabs (компанию-создателя DuckDB). Проекты DuckDB, DuckLake, Quack остаются под MIT-лицензией и управлением DuckDB Foundation. Сообщество восприняло новость со сдержанным оптимизмом благодаря независимому фонду и открытой лицензии. Однако аналитики предупреждают: «разработчики не должны путать неизменность лицензии с неизменностью проекта — люди, пишущие код DuckDB, теперь получают зарплату от AWS, а зарплата влияет на дорожную карту».
  • MotherDuck приобретает Tower.dev для интеграции рантайм-инфраструктуры в MotherDuck Flights — AI-агенты смогут выполнять задачи дата-инжиниринга и публиковать данные как API. Tower — это hosted-рантайм для Python-пайплайнов, обеспечивающий песочницу, планирование и наблюдаемость для кода, написанного LLM.

DuckDB 2.0 preview (кодовое имя «Cyanoptera»)

Доступна preview-версия с клиент/серверным режимом через Quack и `CONNECT`, новым PEG-парсером SQL, переработанным C API для расширений, новым форматом хранения по умолчанию. Асинхронный I/O для S3, переписанный движок рекурсивных CTE и оптимизированный тип VARIANT. Релиз запланирован на октябрь 2026.

Экосистема

Инструмент / Статья Суть
sql.garden Open-source бесконечный холст для данных на Wails (Go + Vue 3) с MCP-сервером для AI-взаимодействия
DuckDB Table Functions in Java Регистрация табличных функций на чистом Java без C++ расширений; векторизованный батч 2048 строк, pushdown предикатов
JetBrains Parquet/Avro/ORC Viewer Плагин для IDE: 1 млрд строк / 29 ГБ Parquet открывается за ~1 сек
Bulk Load в SQL Server (В. Грибанов) Параллельные писатели и явные типы (`MSSQL_NVARCHAR(200)`) ускоряют загрузку 38 млн строк с 933 до 96 сек
DuckLake vs Iceberg (CDC) DuckLake решает проблему мелких файлов в Postgres→DuckDB CDC: 6 576 мс против 269 344 мс у Iceberg COW
duckdb-zarr Rust-расширение для запросов к Zarr-хранилищам (N-мерные массивы) через SQL, поддержка S3/GCS
DuckDB for Apache Iceberg Полноценный read/write lifecycle через REST-каталоги, MERGE INTO, ALTER TABLE, Iceberg V3
SQLite vs DuckDB на $16-железе Для observability-данных DuckDB отодвигает «обрыв чтения» в 100 раз дальше и даёт 4× на метриках, 15× на логах

Эти новости подтверждают вектор: экосистема DuckDB стремительно расширяется от аналитического движка в сторону полноценной платформы данных — с клиент/серверным режимом, AI-интеграцией и корпоративными сценариями. Hugr органично встраивается в эту экосистему, используя DuckDB как вычислительное ядро и добавляя слой декларативного доступа, который превращает сырой движок в управляемую платформу данных.

Работа — боль: как «мазохистическое лидерство» становится системной ловушкой российских компаний — и как из неё выйти

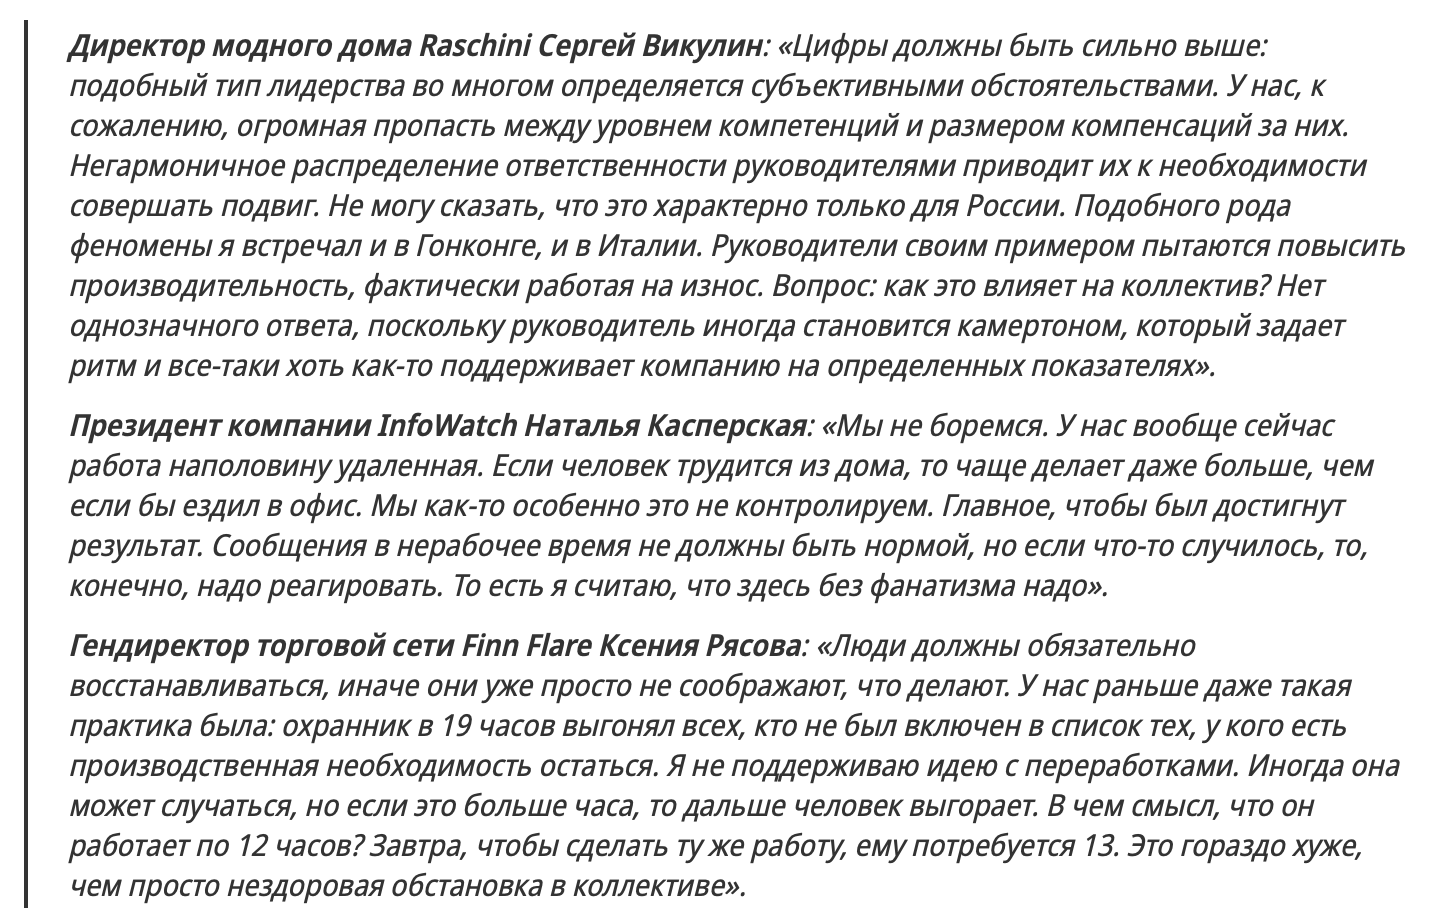
В российской управленческой культуре до сих пор силён образ «настоящего руководителя»: человека, который всегда на связи, спит по четыре часа, лично решает все кризисы и держит команду в постоянном напряжении. Такой начальник не просто работает много — он демонстрирует страдание как доказательство собственной ценности.

Наткнулся на эту статейку, но доступа не имел к сожалению, а написал с ИИшечкой. Не знаю как получилось, вам оценивать.

Кстати там есть еще интересные исследования, вот например такое

можно скачать тут – Игра на нервах Есть еще 28 файлов.

Вот тут еще небольшое введение https://www.kommersant.ru/doc/8956332

Исследование СберУниверситета описывает этот феномен как мазохистическое лидерство. Важно подчеркнуть: речь идёт не о клиническом диагнозе и не о характеристике конкретного человека, а о системной роли, которую организация нередко сама подпитывает и воспроизводит. Логика этой роли проста: если всё спокойно, значит, я недостаточно нужен. Поэтому вокруг лидера регулярно возникают авралы, срочные совещания, ночные переписки и «героические» спасательные операции. Проблема в том, что часто эти пожары создаются самой системой управления — или самим руководителем.

Масштаб явления

По данным исследования СберУниверситета «Игра на нервах? Деструктивные проявления в коммуникациях руководителя» (осень 2024 года, 518 респондентов), 72% сотрудников регулярно сталкиваются хотя бы с одним из девяти видов деструктивного поведения со стороны руководителя. Самое распространённое — отсутствие эмпатии и сочувствия: с этим систематически сталкиваются 54% респондентов, а 87% испытывают негативное воздействие из-за такого поведения — например, когда работают по ночам или в выходные. При этом 42% указывают на слабые управленческие навыки начальства, а 47% демотивирует обесценивание их работы.

Почему такие лидеры появляются

Одна из причин — наследие индустриальной и бюрократической культуры, где ценились дисциплина, терпение и готовность «пахать». Во многих компаниях до сих пор карьерный рост получают не те, кто выстроил устойчивые процессы, а те, кто заметнее всех «тащит», «горит» и «спасает». В такой среде спокойная, предсказуемая работа воспринимается почти как безделье. Если руководитель заранее распределил задачи, убрал лишние согласования и добился результата без драматизма, его вклад может остаться незамеченным. А вот начальник, который в пятницу вечером собирает всех на экстренный созвон и в понедельник докладывает, что «мы выстояли», выглядит героем.

Есть и психологический фактор. Для мазохистического лидера перегрузка становится способом самоутверждения. Он привыкает быть незаменимым, получать признание через жертву и контролировать команду через постоянное напряжение. Иногда такой руководитель искренне уверен, что иначе люди «расслабятся» и работа развалится. Как отмечают эксперты СберУниверситета, за таким поведением часто стоят неосознанные защитные механизмы: руководитель может выступать одновременно в роли «жертвы» обстоятельств и «преследователя» по отношению к подчинённым.

Как страдание становится нормой

Опасность в том, что подобная модель быстро заражает организацию. Сотрудники начинают понимать: ценится не качество результата, а демонстрация вовлечённости. Значит, нужно отвечать ночью, приходить больным, жаловаться на перегрузку, но не отказываться от новых задач. Так формируется негласное правило: хороший работник — тот, кому тяжело.

Со временем компания теряет способность отличать продуктивность от суеты. Совещаний становится больше, решений — меньше. Люди боятся брать паузу, признавать ошибки и говорить о реальных рисках. Хронический стресс снижает внимание, ухудшает качество решений и повышает текучесть кадров. По данным исследования Русской Школы Управления, к концу 2025 года 48% работающих россиян отмечали у себя симптомы эмоционального выгорания, а 68% говорили о постоянной усталости. Выгорание перестаёт быть личной проблемой конкретного человека и становится управленческим дефектом всей системы.

Героизм в кризисе и героизм как норма — не одно и то же

Важно различать два принципиально разных явления. Разовый аврал — когда проект горит из-за внешних обстоятельств, форс-мажора или рыночного шока — это нормальная часть работы. Люди мобилизуются, помогают друг другу, выкладываются больше обычного. Это не патология, а адаптация.

Патология начинается тогда, когда аврал становится хроническим режимом. Если каждая неделя заканчивается «спасением», если дедлайны постоянно сдвигаются, если «ночной созвон» — привычная практика, а не исключение, — значит, проблема не в людях, а в системе. Разовый героизм — это ресурс. Хронический героизм — это его истощение. Компания, которая живёт в режиме постоянного подвига, на самом деле живёт в режиме постоянного управленческого сбоя.

Методика диагностики: диаграмма Исикавы

Чтобы разорвать порочный круг, важно сначала понять, какие именно факторы подпитывают мазохистическое лидерство в конкретной организации. Здесь может помочь диаграмма Исикавы («рыбья кость») — инструмент причинно-следственного анализа, который позволяет структурировать корневые причины проблемы.

«Голова рыбы» — это сама проблема: устойчивое воспроизводство мазохистического лидерства. «Рёбра» — пять узловых блоков, по которым распределяются провоцирующие факторы:

Блок Примеры факторов
Личностный аспект Страх потерять контроль, потребность в признании через жертву, неумение выдерживать неопределённость
Процессы Отсутствие приоритизации, размытые зоны ответственности, культура «тушения пожаров» вместо предотвращения
Среда Героизм вознаграждается, спокойная работа не замечается, страх признать ошибку
Время Хронические переработки, отсутствие пауз, невозможность восстановления
Ресурсы Недоукомплектованность, нехватка полномочий, вынуждающая «всё брать на себя»

Практический алгоритм: соберите рабочую группу из 5–7 человек (руководители, HR, сотрудники), за 30–40 минут сформулируйте проблему в «голове рыбы», затем предложите участникам записать факторы на стикерах и распределить их по блокам. После этого выберите три корневые причины, которые получают больше всего голосов, и под каждую определите одно конкретное действие с ответственным и сроком. Такой анализ позволяет увидеть, что мазохистическое лидерство — не личная патология, а системный сбой, в котором сходятся культурные, управленческие и психологические факторы.

Что могут сделать компании

Первый шаг — перестать поощрять героизм как норму. Компании стоит оценивать руководителей не только по итоговым показателям, но и по тому, какой ценой эти показатели достигнуты. Вот минимальный набор метрик здоровья организации, который стоит отслеживать регулярно:

  • Текучесть кадров — особенно в тех подразделениях, где руководитель демонстрирует мазохистический стиль. Резкий рост — первый сигнал.
  • Уровень выгорания — измеряется через короткие пульс-опросы (например, раз в квартал): «Как часто за последний месяц вы чувствовали эмоциональное истощение?»
  • Доля переработок — процент сотрудников, регулярно работающих сверх нормы. Если он стабильно высок, это не «преданность», а системный сбой.
  • Количество задач, закрытых без аврала — позитивная метрика, которая смещает фокус с «тушения пожаров» на предотвращение.
  • eNPS — полезен, но с оговоркой: он измеряет лояльность, а не выгорание. Исследования показывают, что «промоутеры» могут увольняться чаще всех: парадокс «удовлетворённого увольняющегося». Поэтому eNPS стоит дополнять прямым вопросом: «Планируете ли вы остаться в компании через год?».

Второй шаг — менять систему признания. Награждать нужно не только тех, кто «потушил пожар», но и тех, кто сделал так, чтобы он не начался. Хороший менеджмент часто незаметен: процессы работают, сотрудники понимают цели, риски обсуждаются заранее, решения принимаются без истерики. Именно это и должно считаться профессионализмом.

Третий шаг — учить руководителей работать с тревогой и контролем. Многим начальникам сложно делегировать не потому, что команда слаба, а потому, что они сами не умеют выдерживать неопределённость. Здесь помогают управленческое обучение, коучинг, регулярная обратная связь и честные разговоры о стиле лидерства. Программы психологической поддержки и коучинга для руководителей снижают риск их выгорания и повышают эффективность управления.

Что делать сотрудникам

Если человек оказался в команде мазохистического лидера, важно не подыгрывать культуре страдания. Вот чек-лист красных флагов, которые стоит отслеживать:

  • Срочность без причины — задачи объявляются «горящими», хотя объективных оснований для этого нет.
  • Культ переработок — работать допоздна и в выходные считается нормой, а не исключением.
  • Обесценивание — ваши результаты принижаются или игнорируются, компетентность ставится под сомнение.
  • Наказание за границы — попытка обозначить рабочее время или отказаться от внеурочной задачи воспринимается как нелояльность.
  • Хронический кризис — авралы повторяются каждую неделю, а «герои» регулярно «спасают» проекты.

Если человек оказался в такой среде, важно постепенно переводить разговор из эмоциональной плоскости в управленческую. Например, вместо «мы опять ничего не успеваем» — спрашивать: какие задачи приоритетны? Что можно перенести? Кто принимает решение? Какие риски мы видим заранее? Такой подход возвращает ответственность в систему, а не оставляет её на уровне личного героизма. Полезно фиксировать договорённости письменно, обозначать границы рабочего времени и показывать связь между хаосом и потерей качества. Если руководитель готов к диалогу, это может изменить ситуацию. Если нет — у сотрудника появляется более ясная картина: проблема не в его слабости, а в токсичной управленческой модели.

Что почитать по теме

  • Дэвид Дотлих, Питер Кейро. «Темная сторона силы» — о том, как сильные стороны руководителя превращаются в критические недостатки, и о 11 наиболее распространённых деструкторах.
  • Лора Ловетт. «Токсичный начальник» — практические стратегии для выживания и обретения контроля над карьерой, включая чек-лист для определения типа токсичного руководителя.
  • Кэри Купер. «Организационный стресс» — фундаментальный труд о выгорании как особой форме стресса и организационных условиях его возникновения.
  • Эрих Фромм. «Бегство от свободы» — классический психоаналитический анализ садо-мазохистских механизмов в отношениях власти и подчинения.
  • Исследования СберУниверситета — «Игра на нервах? Деструктивные проявления в коммуникациях руководителя» и «Демотивирующее поведение руководителей» — доступны на сайте организации.

Вместо вывода

Культура страдания держится на мифе, что боль равна эффективности. Но зрелые организации устроены иначе. В них ценится не способность бесконечно терпеть, а умение думать, договариваться, планировать и создавать устойчивые процессы.

Мазохистическое лидерство может выглядеть ярким, самоотверженным и даже искренне преданным делу. Но если компания зависит от постоянных подвигов, значит, она плохо управляется. Настоящая сила руководителя — не в том, чтобы каждый день спасать всех из огня, а в том, чтобы однажды перестать его разводить. И путь к этому начинается с честного взгляда на систему: какие условия мы создаём — и какие условия мы готовы менять.


Бежит кучка ежиков, вдруг вожак орёт: «Стой!!!» — все ежи встали, снова вожак орёт: «Пастись!!!» — все ежи пасутся, а вожак про себя думает: «Хы… Ну чем не кони!»

Помогать легко – DoBro!

Эту простую истину — помогать легко — я открывал для себя не раз, но этим летом она снова напомнила о себе. Особенно когда за абстрактными лозунгами стоят конкретные дела, живое общение и неожиданные встречи. Эта статья о двух событиях, которые случились со мной в течение одного месяца и отлично встряхнули городскую рутину.

День первый: поездка в детский хоспис

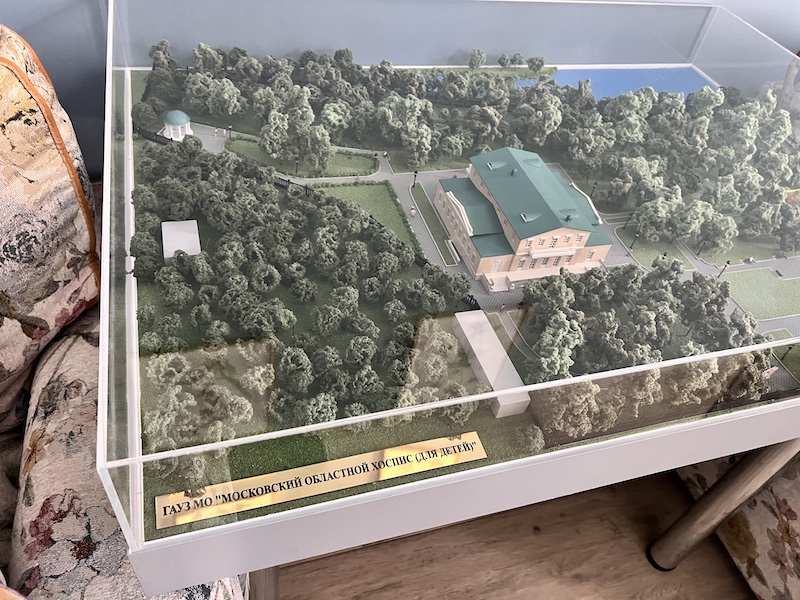
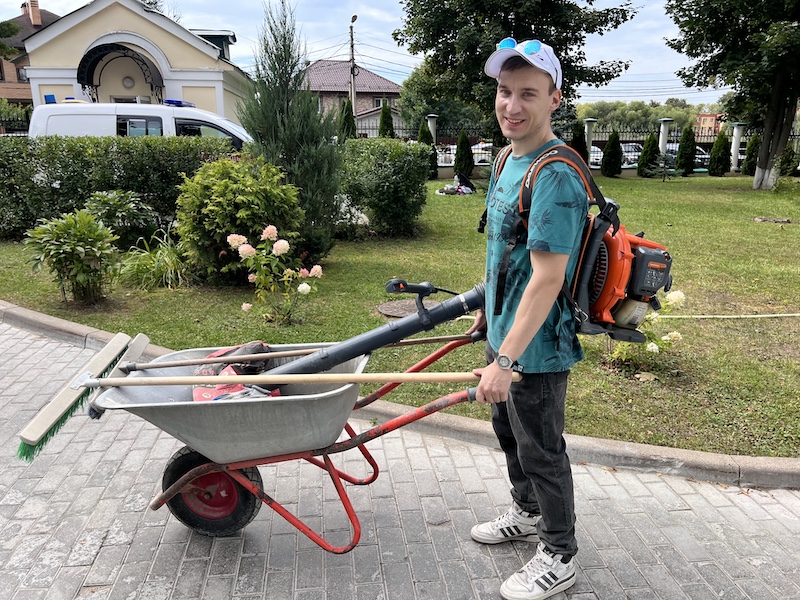
Всю ту неделю я чувствовал, что мне катастрофически не хватает физической активности. Сидячая работа, встречи, дедлайны — тело требовало движения и какой-то разрядки. Но тратить время и силы на спортзал не хотелось — хотелось чего-то нового и свежего. И тут подвернулась возможность съездить от компании в Московский областной хоспис для детей – ГБУЗ МО «МОХД» — помочь с благоустройством территории и по хозяйству.

Это учреждение — первое в Подмосковье и одно из первых в России, оно открылось в 2019 году при поддержке благотворительного фонда «Бумажная птица». Хоспис оказывает паллиативную помощь, и здесь важно всё: не только медицинская, но и социальная, психологическая и духовная поддержка.

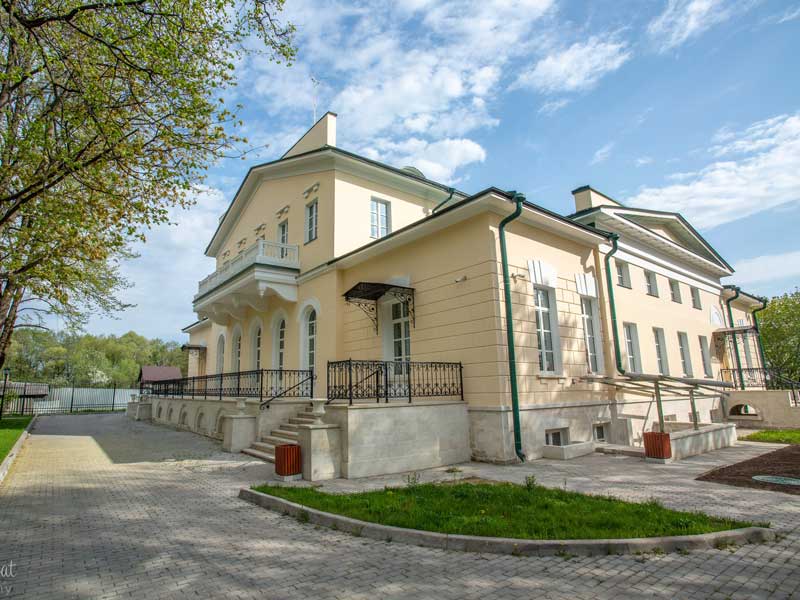
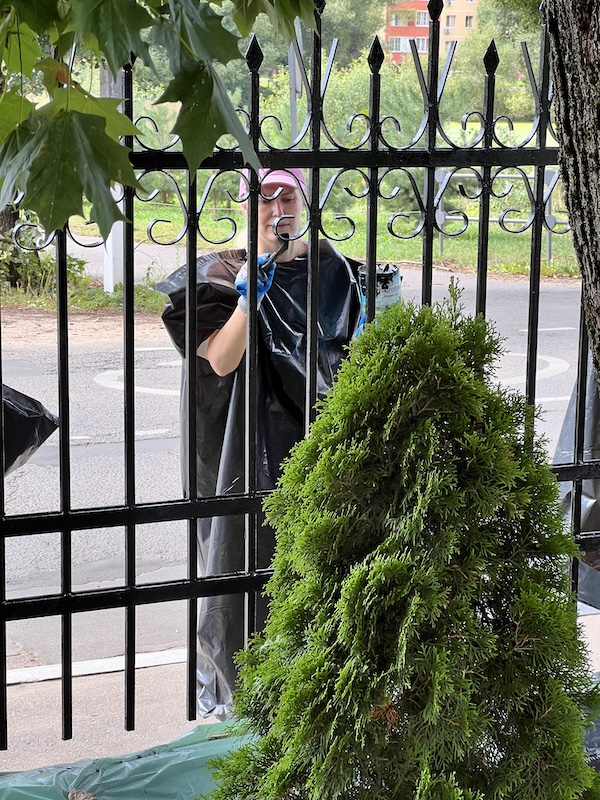
Территория оказалась невероятно красивой. Ухоженный парк, аккуратные дорожки, здание в усадебном стиле — на фотографиях, которые я сделал, это отлично видно. Мы помогали по хозяйству приводить в порядок территорию: что-то подстригали, что-то убирали, где-то просто наводили красоту и красили. Физическая работа на свежем воздухе — именно то, что было нужно. Приехал без задних лап.

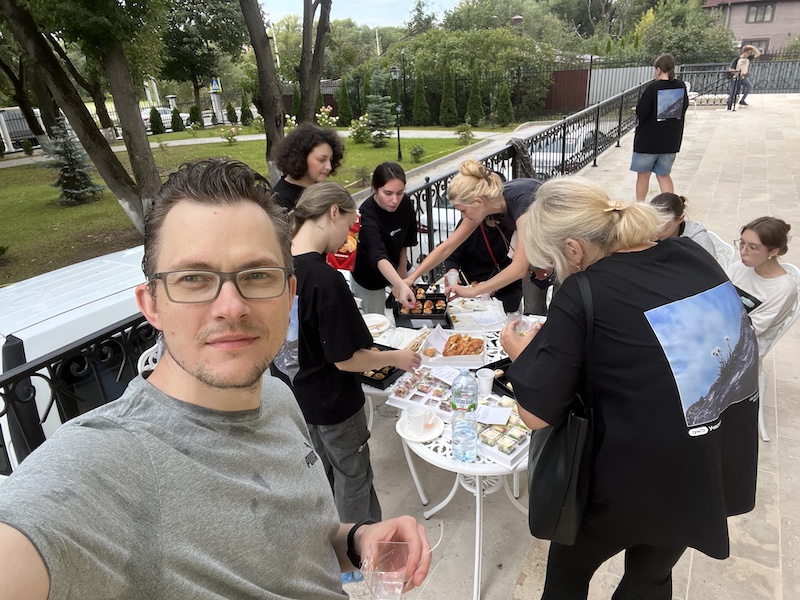
А после — «по-императорски» откушали на террасе. Честно, это был один из самых вкусных и желанных обедов за последнее время. Не потому, что кухня была ресторанной или фуршетной (всё было очень достойно), а потому, что после реального дела и на таком красивом фоне еда воспринимается иначе. В тот день я спал как убитый — коллегам я этого не говорил, но это было фактом. Надо будет повторить — и пользу принёс, и сам отвлёкся от города и текущих дел.

Кстати, если вы тоже хотите найти подобные мероприятия, очень удобно пользоваться платформой dobro.ru (DoBro — «Просто Делай Бро», звучит! :) ) — там собраны тысячи волонтёрских событий: от помощи приютам до экологических акций. Заполняете профиль, выбираете то, что цепляет, подаёте заявку — и вперёд.

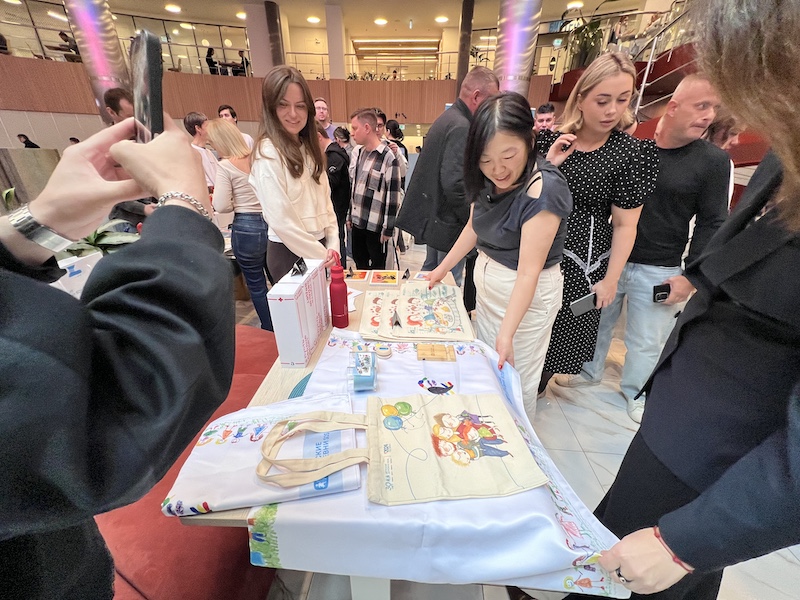
День второй: ярмарка RWB Участие в офисе

А сегодня в офисе прошла благотворительная ярмарка RWB Участие. Это уже не первая такая ярмарка. Два раза утром я проходил мимо, а на третий раз выкроилось время — заглянул и не прогадал. Все три раза, кстати, коллеги толпились вокруг и разглядывали все.

На первой ярмарке я приобрёл стакан для очков «Самое время жить» — маме он очень нравится, пользуется до сих пор. От сегодняшнего визита я не ждал чего-то особенного, но хотелось чего-то необычного, как и в прошлый раз.

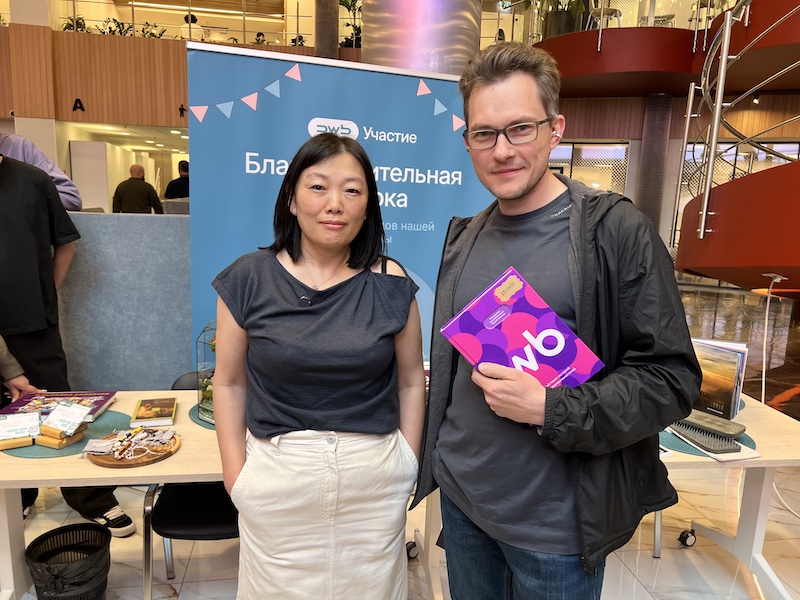
И не прогадал. Во-первых, случайно встретил Татьяну Владимировну Ким — основателя Wildberries, главу РВБ. Встреча была неожиданной, но очень тёплой. Ну и посчастливилось сделать фото на память.

Во-вторых, купил книгу. И да, я знал, что книги есть на Wildberries, но не думал, что их можно купить прямо на ярмарке в офисе. Бумажные книги приятнее покупать физически — прикоснуться к бумаге, полистать. Теперь у меня есть экземпляр с автографом — но его я вам не покажу, это личное :).

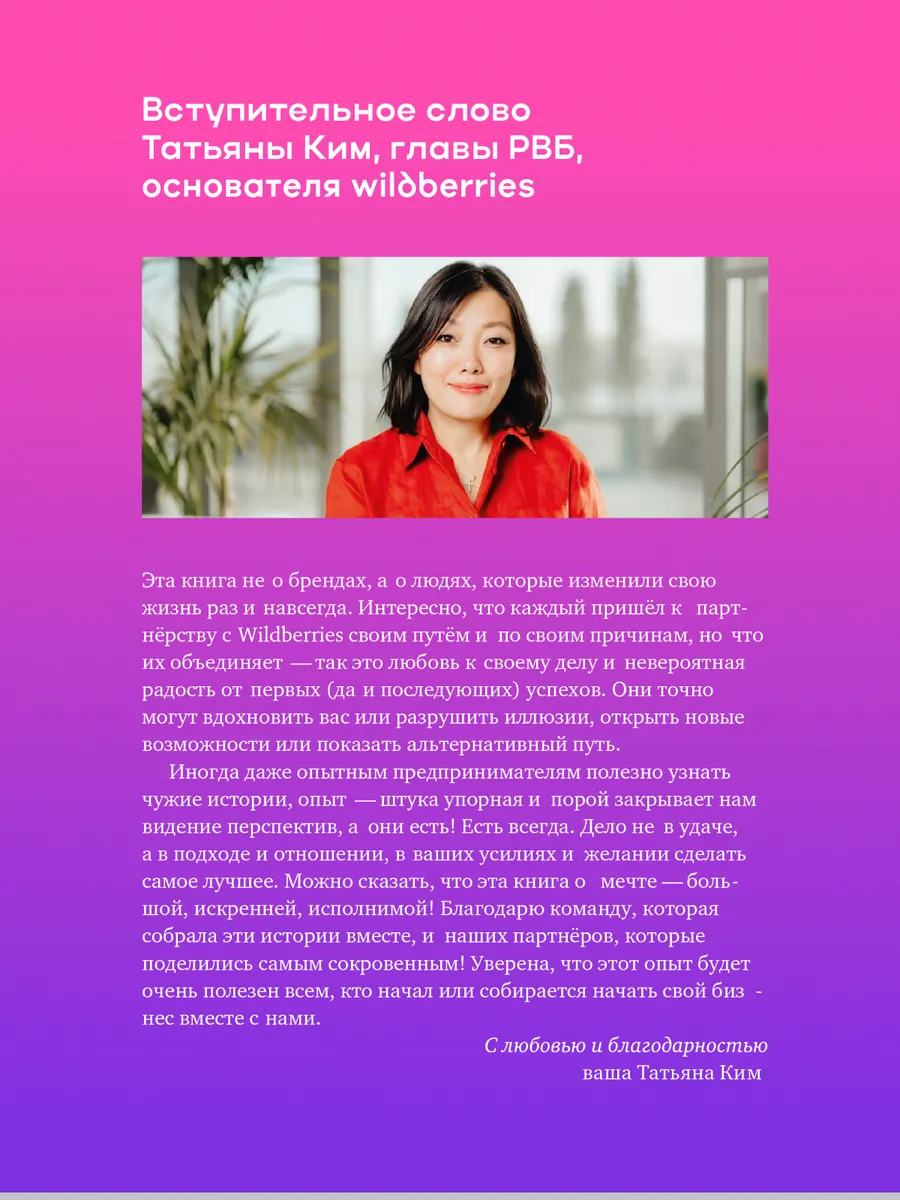
О какой книге речь? О сборнике историй партнёров Wildberries. В предисловии Татьяна Ким пишет:

«Эта книга не о брендах, а о людях, которые изменили свою жизнь раз и навсегда… Дело не в удаче, а в подходе и отношении, в ваших усилиях и желании сделать самое лучшее. Можно сказать, что эта книга о мечте — большой, искренней, исполнимой!»

Пока я ещё не читал эту книгу, но верю, что это действительно так. За каждым успехом стоит не просто удача, а годы труда, ошибок и веры в своё дело.

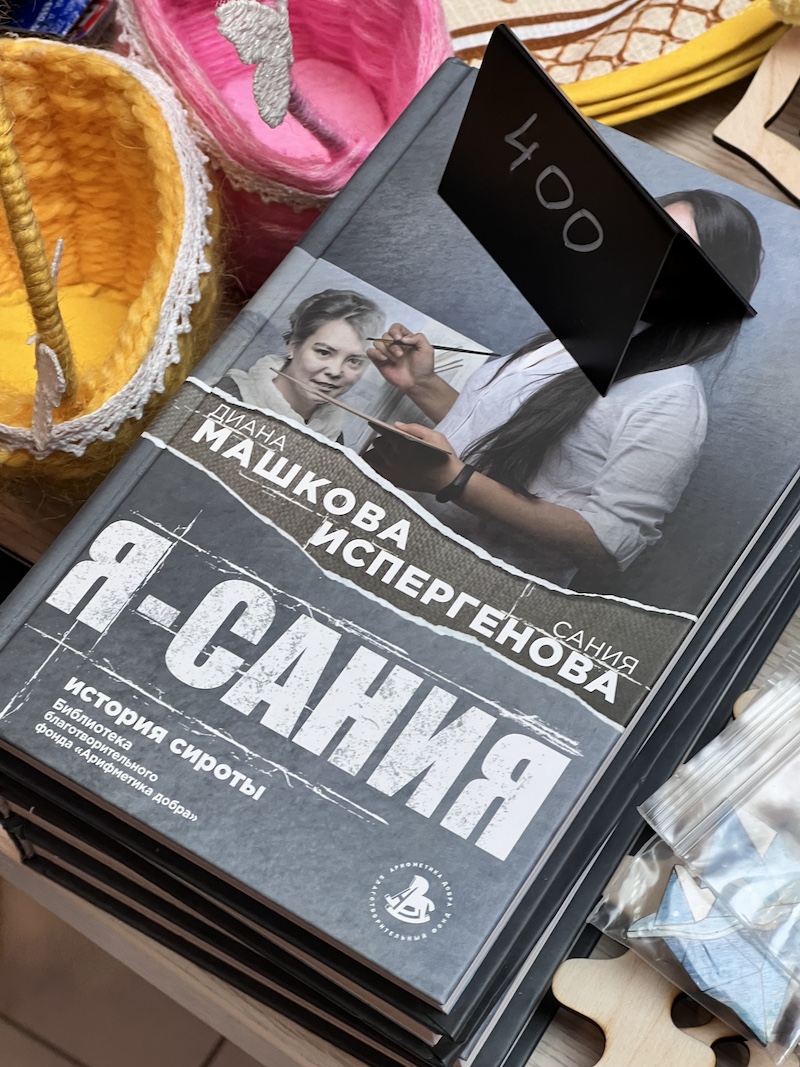
Вторая книга — «Я — Сания» Дианы Машковой и Сании Испергеновой. Это история сироты, написанная в соавторстве с известной писательницей. Книга вышла в рамках проекта «Библиотека благотворительного фонда “Арифметика добра”». Тяжёлая, но важная история. Записал в план на чтение и в закладки.

Почему это важно

Всё это — и поездка в хоспис, и ярмарка — для меня не просто «мероприятия». Это напоминание о том, что помогать легко. Можно найти мероприятие на dobro.ru и поехать волонтёрить. Можно зайти на ярмарку в офисе и купить что-то у фонда. Можно просто перевести деньги через платформу RWB Участие — там собраны верифицированные НКО, и за каждый благотворительный перевод начисляется кешбэк 3% ягодками.

Лето закончилось, но добрые дела не имеют сезонности. Я точно знаю, что буду повторять этот опыт — и в хосписе, и на ярмарках. Потому что после таких дней действительно лучше спишь. И это не только про физическую усталость. Это про ощущение, что день прожит не зря. Кстати, ещё не скоро, но зимой организуется «Ёлка желаний» — тоже очень интересное благотворительное мероприятие, где можно подарить подарки детям и сделать реальностью чью-то мечту.

Trino + OTP верификация запросов в bi – параноя.mode = true

Представьте: дашборд в BI видят все сотрудники. Закрыть его нельзя — так исторически сложилось. Но данные нужно скрыть. Решение — динамическая фильтрация на уровне SQL: пользователь вводит логин и одноразовый код (TOTP), а запрос показывает только те строки, которые ему разрешены.

Это не полноценная система безопасности, но это работающий барьер, который можно внедрить без изменения BI-системы. В статье — пошаговая инструкция: от демо-таблиц до настройки прав в Trino, генерации QR-кодов и увеличения окна действия OTP.


Архитектура

  • `catalog.schema.dashboard_users` — справочник сотрудников: логин, имя, отдел, должность, руководитель, TOTP-секрет, флаг активности.
  • `catalog.schema.dashboard_data` — данные дашборда. У каждой строки есть политика доступа: `ALL`, `OWNER`, `DEPARTMENT`, `MANAGER`, `DIRECTOR`.
  • Функция `verify_totp` — Python UDF, проверяет OTP-код по секрету и текущему времени.
  • Итоговый запрос — аутентифицирует пользователя и фильтрует строки по атрибутам.

Пользователь вводит логин и OTP как параметры BI. Если они верны — получает свои данные. Если нет — пустой результат.


Шаг 1. Демо-таблицы

Создадим две таблицы в вымышленной схеме `catalog.schema`.

CREATE TABLE catalog.schema.dashboard_users (
    login         VARCHAR,
    employee_name VARCHAR,
    department    VARCHAR,
    position_name VARCHAR,
    manager_login VARCHAR,
    totp_secret   VARCHAR,
    is_active     BOOLEAN
);

INSERT INTO catalog.schema.dashboard_users VALUES
    ('vasya', 'Василий', 'sales',    'manager',  'ivan',  'JBSWY3DPEHPK3PXP', true),
    ('petya', 'Пётр',    'sales',    'analyst',  'vasya', 'KRSXG5CTMVRXEZLU', true),
    ('masha', 'Мария',   'finance',  'analyst',  'ivan',  'NB2W45DFOIZA',     true),
    ('ivan',  'Иван',    'management','director', null,   'MFRGGZDFMZTWQ2LK', true);

CREATE TABLE catalog.schema.dashboard_data (
    row_id        BIGINT,
    row_title     VARCHAR,
    amount        DECIMAL(12,2),
    owner_login   VARCHAR,
    department    VARCHAR,
    manager_login VARCHAR,
    access_policy VARCHAR
);

INSERT INTO catalog.schema.dashboard_data VALUES
    (1, 'Личная строка Васи',       1000.00, 'vasya', 'sales',   'ivan',  'OWNER'),
    (2, 'Личная строка Пети',       2000.00, 'petya', 'sales',   'vasya', 'OWNER'),
    (3, 'Общая строка отдела Sales',3000.00, null,    'sales',   null,    'DEPARTMENT'),
    (4, 'Общая строка Finance',     4000.00, null,    'finance', null,    'DEPARTMENT'),
    (5, 'Строка команды Васи',      5000.00, 'petya', 'sales',   'vasya', 'MANAGER'),
    (6, 'Строка команды Ивана',     6000.00, 'masha', 'finance', 'ivan',  'MANAGER'),
    (7, 'Директорская строка',      7000.00, null,    null,      null,    'DIRECTOR'),
    (8, 'Публичная строка',         8000.00, null,    null,      null,    'ALL');

Либо можно сгенерировать коды разово прямо в запросе.

Шаг 1.1. Массовая генерация TOTP-секретов и QR-кодов

Когда пользователей много, вручную придумывать Base32-секреты неудобно. Можно сгенерировать их прямо в Trino при вставке в таблицу `dashboard_users`. Ниже — готовый блок для демо и тестов.

Важно: `random()` в Trino не является криптостойким генератором. Для продакшена секреты лучше генерировать вне Trino (например, через `openssl rand -base64 20` или Python `pyotp.random_base32()`) и вставлять уже готовыми. Для демонстрации и параноидального режима «лишь бы закрыть дашборд» этого достаточно.

Вставка пользователей с автоматической генерацией секретов

INSERT INTO catalog.schema.dashboard_users (
    login,
    employee_name,
    department,
    position_name,
    manager_login,
    totp_secret,
    is_active
)
SELECT
    login,
    employee_name,
    department,
    position_name,
    manager_login,

    -- Генерация Base32-секрета длиной 16 символов (80 бит)
    array_join(
        transform(
            sequence(1, 16),
            i -> substr(
                'ABCDEFGHIJKLMNOPQRSTUVWXYZ234567',
                CAST(floor(random() * 32) + 1 AS INTEGER),
                1
            )
        ),
        ''
    ) AS totp_secret,

    true AS is_active
FROM (
    VALUES
        ('vasya', 'Василий', 'sales',     'manager',  'ivan'),
        ('petya', 'Пётр',    'sales',     'analyst',  'vasya'),
        ('masha', 'Мария',   'finance',   'analyst',  'ivan'),
        ('ivan',  'Иван',    'management','director', CAST(NULL AS VARCHAR))
) AS src (
    login,
    employee_name,
    department,
    position_name,
    manager_login
);

Как получить строку для QR-кода

После вставки можно сразу сформировать URI формата `otpauth://`, который останется только превратить в QR-код любым генератором:

SELECT
    login,
    totp_secret,
    'otpauth://totp/DemoBI:' || login
        || '?secret=' || totp_secret
        || '&issuer=DemoBI' AS otpauth_uri
FROM catalog.schema.dashboard_users;

Пример результата:

login totp_secret otpauth_uri
vasya JBSWY3DPEHPK3PXP otpauth://totp/DemoBI:vasya?secret=JBSWY3DPEHPK3PXP&issuer=DemoBI
petya KRSXG5CTMVRXEZLU otpauth://totp/DemoBI:petya?secret=KRSXG5CTMVRXEZLU&issuer=DemoBI

Эту строку можно вставить в любой генератор QR-кодов (онлайн или офлайн), а затем отсканировать приложением:

  • Google Authenticator,
  • Yandex ID,
  • KeePass (с плагином TOTP),
  • и любым другим менеджером паролей, поддерживающим TOTP.

Настройка длины секрета

  • `sequence(1, 16)` — 16 символов Base32 = 80 бит. Этого достаточно для большинства случаев и именно такую длину часто используют по умолчанию.
  • Если хотите более длинный секрет, замените `16` на `32`. Тогда получится 160 бит.
  • Алфавит `’ABCDEFGHIJKLMNOPQRSTUVWXYZ234567’` — это стандартный Base32-алфавит (без цифр 0, 1, 8, 9). Менять его не нужно.

Если нужен детерминированный секрет (не рекомендуется)

Иногда для тестов хотят, чтобы секрет зависел от логина. Можно использовать хеш:

substr(
    upper(to_base32(from_utf8(login || 'some_salt'))),
    1, 16
) AS totp_secret

Но это небезопасно: зная логин и соль, можно вычислить секрет. Для реальной эксплуатации используйте случайную генерацию вне Trino.


Шаг 2. Inline-функция для тестов в DBeaver

В DBeaver можно использовать `WITH FUNCTION` — Python-код прямо в запросе. Это удобно для отладки, но не работает в BI, потому что BI схлопывает запрос в одну строку и ломает форматирование Python.

WITH FUNCTION verify_totp(secret VARCHAR, code VARCHAR, time_step BIGINT)
RETURNS BOOLEAN
LANGUAGE PYTHON
WITH (handler = 'verify_handler')
AS $$
import hmac, hashlib, struct, base64

def verify_handler(secret_b32, code, time_step):
    if secret_b32 is None or code is None or time_step is None:
        return False

    code = str(code).strip()
    if not code.isdigit() or len(code) != 6:
        return False

    secret = str(secret_b32).strip().replace(" ", "").upper()
    padding = "=" * ((8 - len(secret) % 8) % 8)

    try:
        key = base64.b32decode(secret + padding, casefold=True)
    except Exception:
        return False

    current = int(time_step // 30)   # 30 секунд — стандарт TOTP
    for offset in (-1, 0, 1):
        counter = current + offset
        msg = struct.pack(">Q", counter)
        digest = hmac.new(key, msg, hashlib.sha1).digest()
        o = digest[19] & 15
        expected = (struct.unpack(">I", digest[o:o+4])[0] & 0x7fffffff) % 1000000
        expected_code = f"{expected:06d}"
        if hmac.compare_digest(expected_code, code):
            return True
    return False
$$
SELECT verify_totp('JBSWY3DPEHPK3PXP', '123456', CAST(to_unixtime(now()) AS BIGINT));

Важно: тело функции должно начинаться с новой строки после `$$`. Если BI отправляет всё в одну строку — будет ошибка `Function definition must start with a newline after opening quotes`.


Шаг 3. Регистрация функции администратором

Чтобы BI-запросы не содержали Python-код, функцию нужно создать один раз на стороне Trino. Это делает администратор или пользователь с правами на создание функций.

Сразу еще скажу, что регистрация не во всех каталогах работает, в iceberg например не работает, а вот в iceberg + rest надо проверять. Такая фича давно в плане, но не уверен готова ли. Можно регать функции в каталоге memory конектора, но это придется делать каждую загрузку.

DROP FUNCTION IF EXISTS catalog.schema.verify_totp(VARCHAR, VARCHAR, BIGINT);

CREATE FUNCTION catalog.schema.verify_totp(
    secret VARCHAR,
    code VARCHAR,
    time_step BIGINT
)
RETURNS BOOLEAN
LANGUAGE PYTHON
WITH (handler = 'verify_handler')
AS $$
import hmac, hashlib, struct, base64

def verify_handler(secret_b32, code, time_step):
    if secret_b32 is None or code is None or time_step is None:
        return False

    code = str(code).strip()
    if not code.isdigit() or len(code) != 6:
        return False

    secret = str(secret_b32).strip().replace(" ", "").upper()
    padding = "=" * ((8 - len(secret) % 8) % 8)

    try:
        key = base64.b32decode(secret + padding, casefold=True)
    except Exception:
        return False

    current = int(time_step // 30)
    for offset in (-1, 0, 1):
        counter = current + offset
        msg = struct.pack(">Q", counter)
        digest = hmac.new(key, msg, hashlib.sha1).digest()
        o = digest[19] & 15
        expected = (struct.unpack(">I", digest[o:o+4])[0] & 0x7fffffff) % 1000000
        expected_code = f"{expected:06d}"
        if hmac.compare_digest(expected_code, code):
            return True
    return False
$$;

Проверка:

SELECT catalog.schema.verify_totp(
    'JBSWY3DPEHPK3PXP',
    '465617',
    CAST(to_unixtime(now()) AS BIGINT)
) AS is_valid;

Примечание: в вашей среде создание функции может быть не разрешено без настройки прав. Об этом — следующий шаг.


Шаг 4. Настройка прав доступа

Нужно разрешить группе admins создавать функции в схеме `catalog.schema`, а группе bi_users — только вызывать `verify_totp`. В Trino это делается через system access control.

Вариант A. File-based ACL

Файл `/etc/trino/access-control.properties`:

access-control.name=file
security.config-file=/etc/trino/rules/access-control.json
security.refresh-period=1m

Файл `access-control.json`:

{
  "catalogs": [
    {
      "group": "admins",
      "catalog": "catalog",
      "allow": "all"
    },
    {
      "group": "bi_users",
      "catalog": "catalog",
      "allow": "read-only"
    }
  ],
  "schemas": [
    {
      "group": "admins",
      "catalog": "catalog",
      "schema": "schema",
      "owner": true
    },
    {
      "group": "bi_users",
      "catalog": "catalog",
      "schema": "schema",
      "owner": false
    }
  ],
  "functions": [
    {
      "group": "admins",
      "catalog": "catalog",
      "schema": "schema",
      "function": ".*",
      "privileges": ["EXECUTE", "GRANT_EXECUTE", "OWNERSHIP"]
    },
    {
      "group": "bi_users",
      "catalog": "catalog",
      "schema": "schema",
      "function": "verify_totp",
      "privileges": ["EXECUTE"]
    }
  ]
}

Вариант B. OPA (Rego)

Если Trino использует OPA, политика может выглядеть так:

package trino

default allow := false

is_admin {
    input.context.identity.groups[_] == "admins"
}

is_bi_user {
    input.context.identity.groups[_] == "bi_users"
}

is_target_schema {
    input.action.resource.catalog.name == "catalog"
    input.action.resource.schema.name == "schema"
}

is_verify_totp {
    input.action.resource.catalog.name == "catalog"
    input.action.resource.schema.name == "schema"
    input.action.resource.function.name == "verify_totp"
}

allow {
    is_admin
    is_target_schema
    input.action.operation == "CreateFunction"
}

allow {
    is_admin
    is_target_schema
    input.action.operation == "DropFunction"
}

allow {
    is_admin
    is_target_schema
    input.action.operation == "ExecuteFunction"
}

allow {
    is_bi_user
    is_verify_totp
    input.action.operation == "ExecuteFunction"
}

Точные названия операций (`CreateFunction`, `ExecuteFunction`) лучше уточнить в логах OPA при тестовом запросе.


Шаг 5. Запрос для BI (без Python)

После регистрации функции BI-запрос становится обычным SQL. Пользователь вводит `:login` и `:otp` как параметры.

WITH auth_user AS (
    SELECT
        login,
        employee_name,
        department,
        position_name,
        manager_login
    FROM catalog.schema.dashboard_users
    WHERE login = lower(trim(':login'))
      AND is_active = true
      AND catalog.schema.verify_totp(
            totp_secret,
            trim(':otp'),
            CAST(to_unixtime(now()) AS BIGINT)
          )
    LIMIT 1
)
SELECT
    d.row_id,
    d.row_title,
    d.amount,
    d.owner_login,
    d.department,
    d.manager_login,
    d.access_policy,
    a.login AS current_login,
    a.employee_name AS current_employee_name,
    a.department AS current_department,
    a.position_name AS current_position_name,
    CASE
        WHEN d.access_policy = 'ALL' THEN 'Видно всем авторизованным'
        WHEN d.access_policy = 'OWNER' AND d.owner_login = a.login THEN 'Видно владельцу строки'
        WHEN d.access_policy = 'DEPARTMENT' AND d.department = a.department THEN 'Видно сотруднику отдела'
        WHEN d.access_policy = 'MANAGER' AND d.manager_login = a.login THEN 'Видно руководителю'
        WHEN d.access_policy = 'DIRECTOR' AND a.position_name = 'director' THEN 'Видно директору'
        ELSE null
    END AS access_reason
FROM catalog.schema.dashboard_data d
CROSS JOIN auth_user a
WHERE
       d.access_policy = 'ALL'
    OR (d.access_policy = 'OWNER' AND d.owner_login = a.login)
    OR (d.access_policy = 'DEPARTMENT' AND d.department = a.department)
    OR (d.access_policy = 'MANAGER' AND d.manager_login = a.login)
    OR (d.access_policy = 'DIRECTOR' AND a.position_name = 'director');

Важно про параметры: если BI подставляет их как сырой текст, нужны кавычки: `’:login’`, `’:otp’`. Если BI использует bind-параметры — кавычки не нужны: `:login`, `:otp`. В предыдущих ошибках (`Column ‘jbswy3dpehpk3pxp’ cannot be resolved`) видно, что в вашем случае нужны именно кавычки.


Шаг 6. Логика доступа

  • `auth_user` — возвращает 0 строк, если логин не найден, пользователь неактивен или OTP неверный.
  • `CROSS JOIN auth_user` — если `auth_user` пуст, результат всего запроса пуст.
  • `WHERE` с `OR` — оставляет только те строки, которые разрешены политикой:
    • `ALL` — всем авторизованным;
    • `OWNER` — владельцу (`owner_login = a.login`);
    • `DEPARTMENT` — сотруднику того же отдела;
    • `MANAGER` — руководителю (`manager_login = a.login`);
    • `DIRECTOR` — директору (`position_name = ‘director’`).

Пример: `vasya` увидит свои строки, строки отдела `sales`, строки, где он руководитель, и публичные. `petya` — только свои, отдел `sales` и публичные.


Шаг 7. Генерация QR-кода для OTP

Каждому пользователю нужно выдать TOTP-секрет и удобно передать его в приложение-аутентификатор. Стандартный способ — использовать URI формата `otpauth://`.

Пример для пользователя `vasya`:

otpauth://totp/DemoBI:vasya?secret=JBSWY3DPEHPK3PXP&issuer=DemoBI

Здесь:

  • `DemoBI:vasya` — метка, которая отобразится в приложении. Можно заменить на название отчёта, отдела или что угодно, например `SalesDashboard:vasya`.
  • `secret=JBSWY3DPEHPK3PXP` — Base32-секрет.
  • `issuer=DemoBI` — имя издателя, обычно название компании или системы.

Эту строку можно вставить в любой генератор QR-кодов (онлайн или офлайн). После генерации QR-код сканируется приложением:

  • Google Authenticator,
  • Yandex ID,
  • KeePass (с плагином TOTP),
  • и любым другим менеджером паролей, поддерживающим TOTP.

Это стандарт, поэтому совместимость широкая. QR-код можно распечатать или отправить пользователю.

Совет: если у вас много пользователей, сгенерируйте QR-коды автоматически из таблицы `dashboard_users`, подставляя логин и секрет.


Шаг 8. Увеличение окна действия OTP (2–5 минут)

По умолчанию TOTP-код действует 30 секунд. Это может быть неудобно: пользователь не успевает ввести код. Можно увеличить окно действия, изменив функцию.

В Python-коде есть строка:

current = int(time_step // 30)

Здесь `30` — это количество секунд в одном временном шаге. Если заменить `30` на `300`, то код будет действителен 5 минут (300 секунд). При этом приложение-аутентификатор продолжит генерировать коды каждые 30 секунд, но сервер будет принимать любой код, сгенерированный в течение этих 5 минут. Это удобно и безопасно: окно не бесконечное, но достаточное, чтобы успеть ввести код.

Пример изменённой функции:

current = int(time_step // 300)   # 5 минут
for offset in (-1, 0, 1):
    ...

Если оставить смещения `-1, 0, 1`, то общее окно станет 15 минут (5 минут назад, текущие 5 минут, 5 минут вперёд). Это может быть избыточно. Лучше убрать смещения и проверять только текущий интервал:

current = int(time_step // 300)
counter = current
msg = struct.pack(">Q", counter)
...
# без цикла for

Тогда код будет действителен ровно 5 минут.

Если хотите 2 минуты — используйте `120` вместо `300`.

Важно: после изменения функции её нужно пересоздать ( `DROP FUNCTION` и `CREATE FUNCTION` ). Все пользователи автоматически начнут работать с новым окном.


Шаг 9. Безопасность

  1. Секреты TOTP нельзя хранить в открытой схеме. Лучше вынести `dashboard_users` в закрытую схему, например `security.users`.
  2. BI-пользователи не должны иметь прямой доступ к таблице с секретами. Только к функции и к данным.
  3. OTP-код попадает в логи Trino и BI. Логи могут быть доступны администраторам или храниться в системе. Это не смертельно, потому что код короткоживущий, но помните: любой, кто видит лог, может увидеть введённый OTP. Если окно действия увеличено до 5 минут, риск возрастает. По возможности используйте реального пользователя из аутентификации BI, а не ручной ввод логина.
  4. Права на создание функций — только у группы `admins`. BI-пользователям — только `EXECUTE` на конкретную функцию.

Заключение

Мы построили параноидальный, но рабочий механизм: OTP-аутентификация + динамическая фильтрация строк на уровне SQL. Это не заменяет полноценный RBAC, но позволяет быстро закрыть дашборд от посторонних глаз без изменения BI-системы.

Что проверено: inline-функция в DBeaver, запрос с фильтрацией, логика доступа.
Что требует настройки: регистрация функции и права в Trino. После настройки прав (шаг 4) функция создаётся один раз, а BI-запросы становятся чистыми и безопасными.

Удачи в паранойе! :)

Современный семантический слой на dbt + MetricFlow + DuckDB: макросы вместо пакетов

В этой статье мы построим полностью рабочий семантический слой для аналитики на данных Superstore.csv (от Tableau Desktop, можно скачать его где-то), используя dbt, MetricFlow и DuckDB. Вместо устаревшего пакета `dbt_metrics` (который несовместим с dbt 1.12+), мы применим современный подход — вынесем логику метрик в макросы dbt. Это позволяет централизованно управлять расчётами, автоматически обновлять витрины при изменении метрик и использовать семантический слой для ad-hoc-запросов через `mf`. Все шаги проверены на последних версиях инструментов и готовы к использованию в реальных проектах.


1. Зачем нужен семантический слой и почему макросы — это современный подход?

Семантический слой решает ключевые проблемы аналитики:

  • Единое место определения метрик — бизнес-логика хранится в одном файле.
  • Автоматическая генерация SQL — не нужно писать `GROUP BY`, `JOIN` и агрегации вручную для ad-hoc-запросов.
  • Согласованность — аналитики и BI-инструменты используют одни и те же метрики.

Ранее для использования метрик в моделях применялся пакет `dbt_metrics`, но он несовместим с dbt 1.12 и выше (требует версию <1.6.0). Современный подход — **выносить выражения метрик в макросы dbt**. Это:

  • Не требует внешних пакетов.
  • Работает с любой версией dbt.
  • Даёт полный контроль над SQL.
  • Легко поддерживается и версионируется.

Мы будем использовать:

  • dbt 1.12.4 — для управления моделями и витринами.
  • MetricFlow (встроенный в dbt) — для семантического слоя и ad-hoc-запросов через `mf`.
  • DuckDB 1.5.5 — лёгкая БД для разработки.
  • Макросы dbt — для переиспользования логики метрик в витринах.

2. Установка инструментов и создание проекта

Используем `uv` — быстрый менеджер пакетов Python.

mkdir dbtflow_duck
cd dbtflow_duck

uv init
uv venv
source .venv/bin/activate

uv pip install dbt-duckdb dbt-metricflow pandas duckdb

Проверяем версии (на момент написания):

  • dbt-core: 1.12.4
  • duckdb: 1.5.5
  • metricflow: 0.212.0

3. Загрузка данных Superstore

Скачайте `Superstore.csv` (например, с Kaggle) и поместите в корень проекта.

Создайте `load_data.py`:

import pandas as pd
import duckdb

df = pd.read_csv('Superstore.csv', sep='\t', encoding='latin1')
df.columns = [col.lower().replace(' ', '_').replace('/', '_').replace('-', '_') for col in df.columns]

for col in ['sales', 'discount', 'profit']:
    if col in df.columns:
        df[col] = df[col].astype(str).str.replace(',', '.').astype(float)

df['order_date'] = pd.to_datetime(df['order_date'], dayfirst=True)
df['ship_date'] = pd.to_datetime(df['ship_date'], dayfirst=True)
df['postal_code'] = df['postal_code'].astype(str)

db_path = 'dbtflow_duck.duckdb'
con = duckdb.connect(db_path)

con.execute("DROP TABLE IF EXISTS superstore")
con.execute("""
CREATE TABLE superstore (
    row_id INTEGER, order_id VARCHAR, order_date DATE, ship_date DATE,
    ship_mode VARCHAR, customer_id VARCHAR, customer_name VARCHAR, segment VARCHAR,
    country_region VARCHAR, city VARCHAR, state VARCHAR, postal_code VARCHAR,
    region VARCHAR, product_id VARCHAR, category VARCHAR, sub_category VARCHAR,
    product_name VARCHAR, sales DOUBLE, quantity INTEGER, discount DOUBLE, profit DOUBLE
)
""")

con.execute("INSERT INTO superstore SELECT * FROM df")
print(f"✅ Загружено {len(df)} строк в {db_path}")
con.close()

Запуск:

python load_data.py

4. Инициализация dbt-проекта вручную

Создаём папку проекта и файлы конфигурации (без `dbt init`, чтобы избежать проблем):

mkdir dbt_project
cd dbt_project

dbt_project.yml:

name: 'dbt_project'
version: '1.0.0'
profile: 'dbt_project'

model-paths: ["models"]
analysis-paths: ["analyses"]
test-paths: ["tests"]
seed-paths: ["seeds"]
macro-paths: ["macros"]
snapshot-paths: ["snapshots"]

clean-targets:
  - "target"
  - "dbt_packages"

models:
  dbt_project:
    +materialized: table

profiles.yml:

dbt_project:
  target: dev
  outputs:
    dev:
      type: duckdb
      path: ../dbtflow_duck.duckdb
      schema: main
      threads: 4

Создаём структуру папок:

mkdir -p models analyses tests seeds macros snapshots
export DBT_PROFILES_DIR=$(pwd)
dbt debug   # должно быть All checks passed!

5. Модели данных

models/sources.yml:

version: 2

sources:
  - name: default
    schema: main
    tables:
      - name: superstore

models/superstore_clean.sql:

{{ config(materialized='table') }}

SELECT
    row_id,
    order_id,
    order_date,
    ship_date,
    ship_mode,
    customer_id,
    customer_name,
    segment,
    country_region,
    city,
    state,
    postal_code,
    region,
    product_id,
    category,
    sub_category,
    product_name,
    sales,
    quantity,
    discount,
    profit
FROM {{ source('default', 'superstore') }}

models/time_spine.sql:

{{ config(materialized='table') }}

SELECT 
    CAST(generate_series AS DATE) AS date_day
FROM generate_series(DATE '2020-01-01', DATE '2026-12-31', INTERVAL '1' DAY)

models/metricflow_time_spine.yml (обязательно для MetricFlow):

models:
  - name: time_spine
    description: "A time spine with one row per day for MetricFlow."
    time_spine:
      standard_granularity_column: date_day
    columns:
      - name: date_day
        granularity: day

6. Семантическая модель и метрики

models/superstore.yml:

semantic_models:
  - name: superstore
    model: ref('superstore_clean')
    description: "Superstore sales data"
    defaults:
      agg_time_dimension: order_date
    
    entities:
      - name: order_id
        type: primary
        
    dimensions:
      - name: order_date
        type: time
        type_params:
          time_granularity: day
      - name: category
        type: categorical
      - name: region
        type: categorical
    
    measures:
      - name: total_sales
        agg: sum
        expr: sales
      - name: total_profit
        agg: sum
        expr: profit
      - name: total_discount
        agg: average          # Внимание: не "avg", а "average"!
        expr: discount

metrics:
  - name: total_sales
    label: Total Sales
    type: simple
    type_params:
      measure: total_sales
  - name: total_profit
    label: Total Profit
    type: simple
    type_params:
      measure: total_profit
  - name: avg_discount
    label: Average Discount
    type: simple
    type_params:
      measure: total_discount
  - name: profit_margin
    label: Profit Margin
    type: derived
    type_params:
      expr: total_profit / total_sales
      metrics:
        - total_profit
        - total_sales

Выполняем сборку и генерацию артефактов:

dbt run
dbt parse

7. Ad-hoc-запросы через MetricFlow CLI (`mf`)

Проверяем конфигурацию:

mf validate-configs

Список метрик:

mf list metrics

Вывод:

• avg_discount: metric_time, order_id__category, order_id__order_date, order_id__region
• profit_margin: metric_time, order_id__category, order_id__order_date, order_id__region
• total_profit: metric_time, order_id__category, order_id__order_date, order_id__region
• total_sales: metric_time, order_id__category, order_id__order_date, order_id__region

Примеры запросов:

mf query --metrics total_sales --group-by order_id__category
mf query --metrics profit_margin --group-by order_id__region
mf query --metrics avg_discount --group-by order_id__category

MetricFlow генерирует SQL автоматически — мы не пишем ни строчки кода для этих запросов.


8. Современный подход: макросы для переиспользования метрик в витринах

Вместо устаревшего пакета `dbt_metrics` мы создадим макросы, которые возвращают SQL-выражение для каждой метрики. Это позволяет:

  • Централизованно управлять логикой расчёта.
  • Использовать одну и ту же логику во всех витринах.
  • Легко изменять метрику в одном месте.

macros/get_metric_expr.sql:

{% macro get_total_sales_expr() %}
    SUM(sales)
{% endmacro %}

{% macro get_total_profit_expr() %}
    SUM(profit)
{% endmacro %}

{% macro get_avg_discount_expr() %}
    AVG(discount)
{% endmacro %}

{% macro get_profit_margin_expr() %}
    {{ get_total_profit_expr() }} / NULLIF({{ get_total_sales_expr() }}, 0)
{% endmacro %}

Теперь мы можем строить витрины, используя эти макросы.

models/sales_by_category.sql:

{{ config(materialized='table') }}

SELECT
    category,
    {{ get_total_sales_expr() }} AS total_sales
FROM {{ ref('superstore_clean') }}
GROUP BY category

models/profit_by_region.sql:

{{ config(materialized='table') }}

SELECT
    region,
    {{ get_total_profit_expr() }} AS total_profit,
    {{ get_profit_margin_expr() }} AS profit_margin
FROM {{ ref('superstore_clean') }}
GROUP BY region

models/avg_discount_by_category.sql:

{{ config(materialized='table') }}

SELECT
    category,
    {{ get_avg_discount_expr() }} AS avg_discount
FROM {{ ref('superstore_clean') }}
GROUP BY category

После добавления новых моделей выполняем `dbt run` — все витрины создаются с актуальной логикой метрик.


9. Преимущества подхода с макросами

  • Совместимость — работает с любой версией dbt, без внешних пакетов.
  • Гибкость — можно легко добавлять фильтры, условия, использовать оконные функции.
  • Прозрачность — SQL-код виден и контролируется, его легко отлаживать.
  • Единый источник истины — метрики определены как в YAML (для `mf`), так и в макросах (для витрин).
  • Автоматизация — изменения в макросах автоматически обновляют все витрины при следующем `dbt run`.

10. Расширенный пример: добавление фильтра в метрику

Предположим, нам нужна выручка только для категории “Technology”. Мы можем создать отдельный макрос:

{% macro get_tech_sales_expr() %}
    SUM(CASE WHEN category = 'Technology' THEN sales ELSE 0 END)
{% endmacro %}

И использовать его в витрине:

{{ config(materialized='table') }}

SELECT
    region,
    {{ get_tech_sales_expr() }} AS tech_sales
FROM {{ ref('superstore_clean') }}
GROUP BY region

Это демонстрирует, насколько легко расширять систему без изменения основной семантической модели.


11. Автоматизация пайплайнов

Настройте регулярный запуск `dbt run` в CI/CD или Airflow. При каждом запуске:

  • Обновляются сырые данные (если они загружаются заново).
  • Пересчитываются модели `superstore_clean` и `time_spine`.
  • Пересчитываются все витрины с актуальной логикой метрик из макросов.

Таким образом, ваши отчёты всегда актуальны, а бизнес-логика централизована.


12. Заключение

Мы построили современный семантический слой на стеке dbt + MetricFlow + DuckDB, используя макросы для переиспользования логики метрик в витринах. Этот подход:

  • Не требует устаревших пакетов.
  • Совместим с последними версиями dbt.
  • Даёт полный контроль над SQL.
  • Легко масштабируется и поддерживается.

Все команды проверены и работают на практике. Вы можете адаптировать этот проект под свои данные и метрики, получая все преимущества семантического слоя без лишних зависимостей.

Полезные ссылки:


Huawei Mate XT 2 и Huawei Pura X View

Huawei скоро весь рынок переформатирует :) точнее форм-фрагментирует потом фиг загонят всех обратно в прямоугольники. Ждем телефон для кружочкаф :))

Earlier Ctrl + ↓