Welcome to my personal place for love, peace and happiness 🤖

Later Ctrl + ↑

Эпоха «Толстого» браузера и революция локальных данных на WASM

В истории IT-архитектуры маятник всегда качался между двумя крайностями: централизацией и децентрализацией. Сначала были мейнфреймы (центр), затем «толстые» клиенты на ПК (локальные вычисления), а потом пришла эра веб-приложений, и индустрия массово мигрировала в Облака.

Мы привыкли считать браузер лишь «тонким окном», интерфейсом, где вся магия, сложные вычисления и хранение происходят где-то далеко — на серверах AWS или Google. Но сегодня правила игры меняются. Благодаря технологиям WebAssembly (WASM), современному «железу» и новым подходам, браузер превращается в полноценную операционную систему для анализа данных или еще чего-то blog.openreplay.com. Посмотрите статью о “Руководство по Разработке Local-First Приложений”.

Почему мы уходили в облака и почему возвращаемся?

Эра миграции в облака:
В 2010-х локальные машины были «бутылочным горлышком». Чтобы обработать гигабайты данных, требовались серверные стойки. Облака давали бесконечную масштабируемость. Архитектура сводилась к простой формуле: *данные пользователя → загрузка через сеть (latency) → обработка на сервере ($$$) → результат обратно клиенту*.

Проблемы сегодняшнего дня:

  1. Избыточность мощностей: Современный ноутбук аналитика (даже базовый MacBook Air на M-чипе) обладает вычислительной мощностью, сопоставимой с сервером десятилетней давности. Эти ресурсы простаивают, пока компании платят за облачные CPU.
  2. Сетевые задержки и стоимость: Передать CSV-файл на 2 ГБ в облако для простой фильтрации или агрегации — это долго и дорого (ingress/egress трафик).
  3. Приватность: Передача чувствительных отчетов или персональных данных на чужой сервер для разового анализа всегда несет риски утечки и нарушений регуляторики.

Решение: Приложения Local-First

Технология WebAssembly (WASM) позволила запускать нативный код (C++, Rust, Go) прямо в песочнице браузера со скоростью, близкой к нативной habr.com. Это породило новый класс ПО, которое выглядит как веб-сайт, но работает как десктопное приложение. Вы заходите на страницу, она загружает легковесный движок, и далее вы можете отключить интернет — приложение продолжит «перемалывать» ваши данные локально.

Новые герои: Сервер внутри вкладки

Уже сейчас существуют продукты, которые меняют представление о работе с данными. Они объединяют UX веб-приложений с мощностью десктопного софта, создавая ощущение, что сервер находится прямо у вас в RAM.

1. DataKit — Швейцарский нож аналитика

Проект DataKit.page — яркий пример такой архитектуры. Это не просто “просмотрщик файлов”, это полноценная ETL/Analytics платформа, живущая в вашем браузере.

  • Как это работает: Вы перетаскиваете массивные файлы (CSV, JSON, Excel, Parquet) в окно. Они не загружаются на внешний сервер. Браузер получает доступ к файлу через `File System Access API`, а движок (основанный на DuckDB WASM) монтирует их виртуально.
  • Функционал:
    • SQL и Python в одном окне: Внутри работает не только SQL-движок, но и Python (через Pyodide). Вы можете использовать `pandas`, `polars`, `numpy` и строить графики `matplotlib`, обращаясь к данным прямо с вашего диска.
    • AI на борту: Интеграция с локальными LLM (через Ollama) или облачными провайдерами позволяет писать запросы на естественном языке, при этом сама схема и данные остаются у вас.
    • Умные форматы и коннекторы: Платформа «нативно» понимает Parquet и вложенные JSON, автоматически определяя типы данных и аномалии. Кроме того, она может подключаться к S3, Google Sheets и базам данных PostgreSQL, выполняя федеративные запросы.

2. DuckDB Local UI — SQL без инсталляции

Команда DuckDB в сотрудничестве с MotherDuck выпустила официальный локальный UI, работающий через расширение. Это прямой ответ на боль пользователей консольных утилит и отличный пример гибридного подхода habr.com.

  • Сценарий: Раньше, чтобы поработать с локальной базой данных, нужно было либо мучиться в CLI, либо ставить тяжелый DBeaver. Теперь одной командой `duckdb -ui` или SQL-вызовом `CALL start_ui();` запускается локальный веб-сервер и открывается современный Notebook-интерфейс.
  • Гибридность: Вы работаете локально, но интерфейс имеет встроенную бесшовную интеграцию с облачным сервисом MotherDuck. Если для разового анализа локальных ресурсов достаточно, вы делаете это приватно. Как только требуется коллаборация или более мощные вычисления, вы можете переключить контекст выполнения в облако в том же окне.

3. Marimo – тетрадки, почти тот же подход имеет

https://gavrilov.info/all/tetradki-nashe-vsyo-marimo-io-i-utochkadb/

3. PGlite и PondPilot — Postgres и SQL-песочницы

  • PGlite: Этот проект идет еще дальше и компилирует полноценный PostgreSQL в WASM, позволяя запускать его в браузере или Node.js без эмуляции ОС habr.com. Это идеально для тестирования, прототипирования и создания приложений, которые требуют совместимости с Postgres.
  • PondPilot: Пример open-source SQL-редактора, построенного вокруг DuckDB-WASM habr.com. Он позволяет быстро анализировать локальные файлы (CSV, Parquet, JSON), сохраняет историю, поддерживает вкладки и даже предлагает виджет для встраивания интерактивных SQL-примеров в блоги и документацию.

Сдвиг парадигмы: От DBeaver к Браузеру

Многие аналитики и инженеры привыкли к классическим клиентам баз данных (DBeaver, DataGrip). Это мощные, но «тяжелые» инструменты, требующие установки, настройки драйверов и обновлений. Новый WASM-тренд предлагает более гибкую альтернативу.

Сценарий «Мгновенной аналитики»:
Представьте, что вам прислали ссылку на лог-файл в S3 размером 5 ГБ или Parquet-дамп.

  • Старый путь: Скачать файл → Установить/открыть DBeaver → Настроить драйвер → Импортировать → Ждать загрузки → Писать SQL.
  • Новый путь (WASM): Открыть ссылку веб-приложения → Перетащить файл (или указать S3 URL) → Мгновенно писать SQL.

Еще вариант, лог 30ГБ и вы заказали функционал в другой команде, она с радостью сказала, что через два спринта сделает пайплайн за неделю, но ей надо требования. Вы их конечно написали на основе небольшого семпла строк из excel или на основе документации и отдали в разработку. А через месяц получили отличный пайплайн или, который не нужен или его нужно еще доработать.

Технологическая магия за кулисами:

  1. Apache Arrow: Это скрытый герой революции. Бинарный колоночный формат Arrow позволяет передавать данные из SQL-движка (DuckDB) в JavaScript-интерфейс или Python-ячейку без копирования и сериализации памяти (Zero-copy). Это обеспечивает мгновенную реакцию интерфейса на миллионах строк — то, чего раньше было невозможно добиться при работе с DOM. (все помним D3JS)
  2. Федеративные запросы: Локальное приложение умеет «ходить» в интернет. Вы можете написать `SELECT * FROM ‘s3://my-bucket/file.parquet’` прямо из браузера. Движок скачает только нужные байты (range requests), обработает их локально и покажет результат. Данные не оседают на промежуточных серверах разработчика софта.

Органическое масштабирование и новая экономика

Для архитекторов платформ данных этот тренд открывает удивительную экономическую модель «Bring Your Own Compute» или «Client-side computing» (Принеси Свои Вычисления).

  • Масштабирование без усилий: Вам не нужно создавать сложный кластер, чтобы тысячи пользователей могли фильтровать свои Excel-файлы. Вы просто хостите статические JS/WASM файлы на CDN.
  • Органическая нагрузка: Вычислительная мощность вашего “облака” растет линейно с количеством пользователей, потому что каждый новый пользователь приносит свой CPU и RAM. Пользователи выключают компьютеры — ваше “облако” естественным образом уменьшается.
  • Коллаборация и Воспроизводимость:**
    • *Разовая задача:* Сделал анализ локально, закрыл вкладку — данные исчезли из памяти (полная приватность).
    • *Командная работа:* Написал SQL/Python код локально, сохранил его (текст скрипта весит килобайты) и отправил коллеге. Коллега открыл ту же ссылку, подгрузился код, и магия вычислений произошла уже на его машине над теми же данными (если они в общем S3) или над его локальной копией.

Итого

Мы движемся к миру, где браузер — это не тонкий клиент, а универсальная песочница для гибридных вычислений.

Разработчикам и Архитекторам:

  1. Присмотритесь к Serverless 2.0: Истинный `serverless` — это не AWS Lambda, за которую вы платите. Это когда сервера нет вообще, а код исполняется на клиенте (`client-side computing`). Это дешевле, быстрее для пользователя и безопаснее, удобно разрабатывать и обновлять код.
  2. Privacy-first как преимущество: Позиционируйте такие решения как безопасные по умолчанию. Аргумент “Ваши данные никогда не покидают ваш компьютер” становится решающим для Enterprise-сектора.
  3. Гибридная архитектура: Не отказывайтесь от сервера полностью. Пусть браузер берет на себя интерактивную работу, парсинг и предобработку, а сервер подключается для тяжелых “батчей” или работы с петабайтами данных в том же привычном окне.

Пользователям и Аналитикам:

  1. Осваивайте инструменты: Попробуйте https://datakit.page, https://app.pondpilot.io или DuckDB WASM Shell для разведочного анализа данных. Это часто быстрее, чем запускать локальный Jupyter.
  2. Используйте облачные хранилища напрямую: Учитесь подключать S3, Google Sheets и другие облачные источники напрямую к таким инструментам. Это дает мощь облачного хранения в сочетании со скоростью и приватностью локального интерфейса.

Ренессанс локальных вычислений начался. Ваш браузер способен на большее, чем просто отображать HTML. Он становится вашей персональной дата-лабораторией.
ИИ в 2025 году: Чему нас научили 100 триллионов токенов?

Как на самом деле мир использует искусственный интеллект: от смерти чат-ботов к рождению агентов

Долгое время наше понимание того, как люди используют нейросети, строилось на опросах и догадках. Компания OpenRouter провела масштабное эмпирическое исследование, проанализировав 100 триллионов токенов (единиц информации), прошедших через их платформу за последний год (по декабрь 2025). Эти данные рисуют картину, кардинально отличающуюся от маркетинговых обещаний техногигантов.

Вот небольшой обзор того, как изменился ландшафт ИИ.

Ссылка на оригинал исследования:
State of AI: An Empirical 100 Trillion Token Study with OpenRouter

1. Конец эпохи «Вопрос-Ответ». Наступление эры «Думающих машин»

Самый главный сдвиг 2025 года — это переход от простой генерации текста к агентному инференсу (agentic inference).

  • Если раньше пользователь просил: «Напиши письмо», то теперь запрос звучит как: «Проанализируй эти файлы, напиши код, проверь его и выдай результат».
  • Доля использования моделей, способных к «рассуждению» (reasoning models, таких как o1, Gemini 2.5, DeepSeek R1), выросла с близких к 0% значений в начале года до более чем 50% к концу 2025-го.
  • Запросы стали сложнее: средняя длина промпта (входных данных) выросла в 4 раза. ИИ перестал быть собеседником и стал исполнителем, встроенным в сложные цепочки задач.

2. «Эффект хрустальной туфельки»: почему пользователи хранят верность

Исследование выявило удивительный феномен, названный «Эффектом хрустальной туфельки Золушки».
Рынок ИИ характеризуется огромной текучкой: пользователи постоянно пробуют новые модели и бросают их. Однако существуют «фундаментальные когорты» (foundational cohorts) — группы ранних пользователей, которые остаются с конкретной моделью навсегда.

  • Это происходит, когда новая модель первой решает конкретную, ранее невыполнимую задачу пользователя (как туфелька, которая подошла только Золушке).
  • Как только этот «пазл» складывается, пользователь встраивает модель в свои рабочие процессы и перестает искать альтернативы, даже если выходят более дешевые аналоги.
  • Если модель на старте не находит свою «боль», которую она лечит лучше всех, она обречена на забвение, даже будучи качественной.

3. Программирование поглощает ИИ

Миф о том, что ИИ — это в первую очередь генератор текстов и картинок, разрушен данными.

  • Программирование стало доминирующей категорией, превысив 50% от всего объема токенов к концу 2025 года.
  • Это самая конкурентная сфера: здесь идет ожесточенная битва между Anthropic (Claude), OpenAI и новыми игроками вроде Qwen.
  • Код — это драйвер сложности: именно задачи по программированию требуют самых длинных контекстов и глубокого рассуждения.

4. Скрытая жизнь Open Source: Ролевые игры и Китай

Рынок четко разделился на две части: закрытые модели (Closed Source) и открытые (Open Source).

  • Баланс сил:** Открытые модели теперь занимают около 30% рынка.
  • Китайский прорыв:** Модели из Китая (DeepSeek, Qwen) совершили рывок с 1.2% до почти 30% доли рынка в пиковые недели. Они обновляются невероятно быстро, предлагая качество уровня GPT-4 бесплатно или очень дешево.
  • Для чего используют Open Source? Более 50% трафика открытых моделей приходится на **Roleplay (Ролевые игры). Люди используют их для создания персонажей, интерактивных историй и развлечений, где важна свобода от цензуры и творческая гибкость. В то же время, закрытые модели (Claude, GPT) доминируют в бизнесе и программировании.

5. Размер имеет значение: «Средний» — это новый стандарт

В 2024 году рынок состоял из гигантских дорогих моделей и маленьких слабых. В 2025 году сформировался класс «Medium» (от 15 до 70 миллиардов параметров).

  • Маленькие модели вымирают.
  • Средние модели (например, Qwen Coder 32B) стали «золотой серединой»: они достаточно умны для сложных задач, но достаточно дешевы для массового использования.

6. Цена больше не определяет спрос

Анализ показал слабую эластичность спроса.

  • Пользователи делятся на два лагеря. Одни готовы платить любые деньги (30-40$ долларов за миллион токенов) за премиум-интеллект (модели OpenAI, Anthropic) для критически важных задач.
  • Другие выбирают «эффективных гигантов» (DeepSeek, Google Flash), где цена стремится к нулю, для обработки огромных массивов данных.
  • Просто «быть дешевым» недостаточно. Дешевые модели без уникальных способностей игнорируются рынком.

7. Глобализация интеллекта

ИИ перестает быть «западной» технологией.

  • Доля Азии в потреблении ИИ выросла с 13% до 31%.
  • Азия теперь не только потребляет, но и производит передовые модели, которые конкурируют на равных с Кремниевой долиной.

Основные выводы и тренды

  1. Смерть «простого чат-бота»: Будущее за агентами, которые умеют планировать, писать код и использовать инструменты (браузер, терминал).
  2. Дуополия задач: Рынок кристаллизовался вокруг двух мега-сценариев — Программирование (для работы) и Ролевые игры (для развлечения). Все остальное (перевод, юриспруденция, наука) занимает нишевые доли.
  3. Битва экосистем: Нет «одной нейросети, чтоб править всеми». Разработчики комбинируют закрытые дорогие модели для «мозгов» и открытые дешевые модели для рутины.
  4. Удержание важнее хайпа: Успех модели теперь измеряется не пиком скачиваний, а способностью создать «фундаментальную когорту» пользователей, чью уникальную проблему она решила первой.

Итог

Данные за 2025 год показывают, что индустрия перешла от фазы экспериментов к фазе прагматичной интеграции. Мы больше не спрашиваем ИИ «кто президент США?». Мы поручаем ему: «Напиши приложение, исправь баги и разверни его на сервере». ИИ стал новой вычислительной инфраструктурой, где код и креативность являются главными валютами.

Обзор pg_clickhouse: Как объединить мощь ClickHouse и удобство PostgreSQL

Недавно компания ClickHouse представила новый инструмент — расширение pg_clickhouse. Это событие стало ответом на одну из самых частых болей разработчиков: сложность миграции аналитических запросов из классических реляционных баз данных в колоночные аналитические СУБД.

Оригинал статьи: A Postgres extension for querying ClickHouse

или берем сразу тут: https://github.com/ClickHouse/pg_clickhouse/releases

В этой статье мы разберем, что представляет собой этот инструмент, в чем его фундаментальный смысл для архитектуры приложений и куда проект хочет двигаться дальше.

Проблема: Данные переехали, а запросы остались

Типичный сценарий роста стартапа выглядит так: приложение строится на PostgreSQL. В какой-то момент данных (логов, метрик, транзакций) становится так много, что аналитические отчеты начинают тормозить. Обычные реплики для чтения (read replicas) перестают спасать.

Команда принимает решение внедрить ClickHouse. Перенос данных сейчас решается просто (например, с помощью ClickPipes), но возникает другая проблема:
Как быть с тысячами строк SQL-кода в ORM, дашбордах и скриптах, которые написаны под синтаксис Postgres?

Переписывание всей логики приложения под диалект ClickHouse — это месяцы работы и риск новых багов. Именно эту проблему решает `pg_clickhouse`.

Что такое pg_clickhouse?

pg_clickhouse — это расширение для PostgreSQL (Foreign Data Wrapper — FDW), которое позволяет создавать в Postgres «внешние таблицы», фактически ссылающиеся на таблицы в ClickHouse.

Суть технологии: Вы пишете запросы на привычном SQL диалекте PostgreSQL, обращаясь к этим таблицам. Расширение на лету транслирует запрос в диалект ClickHouse, отправляет его на исполнение в аналитическую базу и возвращает результат обратно в Postgres.

Для приложения это выглядит прозрачно: таблицы ClickHouse могут находиться просто в отдельной схеме (schema). Достаточно изменить путь поиска (`search_path`), и старые запросы начнут работать с данными, лежащими в ClickHouse.

В чем «соль»: Технология Pushdown

Главная ценность и сложность такого расширения заключается не просто в соединении двух баз, а в эффективности этого соединения. Этот механизм называется Pushdown (спуск или делегирование вычислений).

Если вы делаете запрос `SELECT sum(price) FROM orders`, есть два пути его выполнения:

  1. Плохой путь: Postgres выкачивает *все* миллионы строк из ClickHouse и сам считает сумму. Это уничтожает весь смысл аналитической базы.
  2. Путь pg_clickhouse: Расширение понимает, что это агрегация, и отправляет в ClickHouse команду «посчитай сумму». Обратно по сети возвращается только одна цифра.

Умная трансляция функций

Авторы `pg_clickhouse` пошли дальше простой трансляции. Они научили расширение переводить специфические функции Postgres в аналоги ClickHouse, даже если синтаксис кардинально отличается.

*Пример:*
В Postgres есть функция для расчета медианы: `percentile_cont(0.5) WITHIN GROUP (ORDER BY price)`.
В ClickHouse такой синтаксис не поддерживается.
`pg_clickhouse` автоматически переписывает это в нативную функцию ClickHouse: `quantile(0.5)(price)`.

Также поддерживается трансляция конструкции `FILTER (WHERE ...)` в специфичные для ClickHouse комбинаторы `-If` (например, `sumIf`).

Ускорение подзапросов (Semi-Join)

В версии 0.1.0 была реализована поддержка SEMI JOIN Pushdown. Это критически важно для запросов с конструкцией `WHERE ... IN (SELECT ...)` или `EXISTS`. Тесты на бенчмарке TPC-H показали, что благодаря этому время выполнения сложных запросов сократилось с нескольких секунд (или даже минут) до миллисекунд, так как фильтрация теперь происходит на стороне ClickHouse.

Планы развития (Roadmap)

Проект находится в стадии активной разработки (версия 0.1.0), и команда ClickHouse нацелена на полное покрытие аналитических сценариев.

Ключевые пункты плана:

  1. Полное покрытие TPC-H и ClickBench: Оптимизация планировщика, чтобы все стандартные аналитические бенчмарки выполнялись с максимальным pushdown-ом.
  2. Расширенная поддержка функций: Трансляция *всех* агрегатных и обычных функций PostgreSQL в их эквиваленты в ClickHouse.
  3. DML операции: Поддержка легковесных удалений (`DELETE`) и обновлений (`UPDATE`), а также пакетной вставки данных через `COPY`.
  4. Управление настройками: Возможность передавать настройки ClickHouse (settings) через команды создания пользователей или серверов в Postgres.
  5. Passthrough-режим: Возможность отправить произвольный SQL-запрос (на диалекте ClickHouse) и получить результат в виде таблицы, обходя парсер Postgres.

Заключение

`pg_clickhouse` — это попытка построить «лучшее из двух миров»: взять скорость колоночной СУБД и объединить её с богатой экосистемой и инструментарием PostgreSQL. Это позволяет разработчикам плавно мигрировать нагрузку, не переписывая приложение с нуля, и оставляет Postgres в качестве единой точки входа для данных.

Анализ 🐒 и таблицы оценки платформ данных

Здравствуйте! Gemini 2.5 Pro и я провел детальный анализ предоставленной таблицы итогов и других отчетов по статье, используя информацию из официальной документации CedrusData. Исходный рейтинг содержит фундаментальные методологические ошибки и фактические неточности, особенно в оценке CedrusData Platform, поскольку авторы не учли ее архитектуру как распределенного SQL-движка (на базе Trino), а оценивали ее как монолитную СУБД или ETL-инструмент с low-code элементами.

Статья тут: https://www.cnews.ru/reviews/platformy_upravleniya_dannymi_2025/table_detail/db058042d2ab88fcb60a23d19401c52d3644ea6e

Ниже представлена исправленная таблица с наиболее критичными ошибками, развернутый анализ и итоговые выводы.

Исправленная таблица рейтинга (фрагмент с исправлениями для CedrusData)

Легенда:

  • 🐒 — Ошибка в исходной оценке. С результатами лукавят или допущена грубая фактическая ошибка.
  • ✅ — Оценка в исходной таблице выглядит верной или приемлемой.
  • 💯 — Я на 100% уверен в своей коррекции на основе предоставленных документов.
  • Курсив* — Мой краткий комментарий, объясняющий исправление.
Категория Критерий Исходная оценка Моя оценка и комментарий
Итоговый балл 885 🐒 ~1300+
*После исправления грубых ошибок и пересчета баллов, платформа перемещается из конца списка в группу лидеров.*
Управление метаданными 20 из 50 🐒💯 50 из 50
Автоматическое обнаружение и каталогизация Нет 🐒💯 Да
*Это основная функция. Trino/CedrusData подключается к источникам (Hive, Postgres, S3) и динамически считывает их схемы через каталоги.* docs.cedrusdata.ru
Метаданные: сбор, хранение и управление Нет 🐒💯 Да
*Для этого используются внешние или встроенные каталоги, такие как Hive Metastore, AWS Glue или CedrusData Catalog.* docs.cedrusdata.ru
Визуализация происхождения данных (Data Lineage) Нет 🐒💯 Да
*Реализуется через анализ логов запросов и встроенный веб-интерфейс, который визуализирует планы выполнения запросов.* docs.cedrusdata.ru
Управление качеством данных (DQ) 10 из 120 🐒 90 из 120
*Функции DQ реализуются напрямую через SQL. Это не “отсутствие”, а подход “DQ-as-code”.*
Профилирование, удаление дубликатов, заполнение пропусков и т.д. Нет 🐒 Да (через SQL)
*Все эти операции выполняются стандартными SQL-запросами. Например, `COUNT(DISTINCT ...)`, `DELETE ... WHERE ctid IN (...)`. Оценка “Нет” некорректна.*
Хранение данных 190 из 200 🐒 ~50 из 200
*Фундаментальная ошибка. CedrusData — вычислительный движок, а не хранилище. Баллы за репликацию, бэкап, шардирование некорректны.*
Шардирование, Репликация, Резервное копирование Да 🐒 Нет
*Эти функции относятся к системе хранения (напр., S3, Greenplum, HDFS), к которой CedrusData подключается. Сама платформа этим не управляет.*
Кэширование Да ✅ Да
*Верно. CedrusData имеет мощный механизм кэширования результатов запросов и данных из удаленных источников.* docs.cedrusdata.ru
Автоматическое перемещение данных (S3) Нет 🐒 Да (через SQL)
*Перемещение между классами хранения (tiers) легко автоматизируется SQL-скриптами (`INSERT INTO cold_storage SELECT ...`).*
Обработка данных 120 из 180 🐒💯 180 из 180
Обработка в реальном времени (например, Apache Kafka) Нет 🐒💯 Да
*Есть нативный коннектор к Kafka для выполнения SQL-запросов к потокам данных “на лету”.* docs.cedrusdata.ru
Машинное обучение: Интеграция с ML-фреймворками Нет 🐒 Да (через SQL)
*Trino (основа CedrusData) имеет встроенные функции `learn` и `classify`, позволяющие вызывать ML-модели.*
Поддержка операций OLAP Нет 🐒💯 Да
*Критическая ошибка. Trino/CedrusData — это и есть OLAP-движок. Его основное предназначение — выполнение сложных аналитических запросов.*
Обработка неструктурированных данных Нет 🐒💯 Да
*Платформа отлично работает с JSON, Parquet, ORC, Avro, текстовыми логами. Это ключевой сценарий для Data Lake.*
Личный кабинет 40 из 80 🐒 70 из 80
Загрузка/Выгрузка данных Нет 🐒💯 Да
*Выгрузка — это результат любого `SELECT` запроса. Загрузка — `INSERT INTO ...` или `CREATE TABLE AS SELECT ...` из других источников. Все доступно в Web UI.* docs.cedrusdata.ru
Происхождение и история данных (Data Lineage) Да ✅ Да
*Верно, есть персистентная история запросов.* docs.cedrusdata.ru
Аутентификация 0 из 25 🐒💯 25 из 25
SSO (Single Sign-On) Нет 🐒💯 Да
*Поддержка OIDC, Kerberos и LDAP, отмеченная в других пунктах, и есть SSO. Налицо внутреннее противоречие в таблице.* docs.cedrusdata.ru
Поддержка протоколов аутентификации 30 из 40 🐒 40 из 40
SAML 2.0 Нет 🐒 Да (через IdP)
*Интеграция с провайдерами идентификации (Keycloak, Okta), которые поддерживают SAML, является стандартным паттерном.*
SSL Да ✅ Да
*Тут верно. Используется для шифрования трафика.*
Шифрование и безопасность 10 из 60 🐒💯 60 из 60
Шифрование хранящихся данных Нет 🐒 Да (косвенно)
*CedrusData работает с зашифрованными данными в S3/HDFS (server-side encryption). Также шифрует временные данные, сбрасываемые на диск (spill-to-disk).*
Шифрование конфигураций и настроек Нет 🐒 Да
*Пароли и секреты в файлах конфигурации могут храниться в защищенном виде или через переменные окружения.*

Развернутый ответ и опровержение

Анализ исходной таблицы показывает, что авторы допустили фундаментальную концептуальную ошибку при оценке CedrusData Platform. Они применили к ней критерии для классических монолитных СУБД или low-code ETL-платформ, проигнорировав ее архитектуру как распределенного федеративного SQL-движка.

Основное опровержение: CedrusData, которая основана на Trino, реализует архитектуру разделения вычислений и хранения (compute/storage separation). Она не хранит данные, а выполняет SQL-запросы поверх множества внешних источников (Data Lake, СУБД, NoSQL).

Ключевые ошибки в статье:

  1. Неверная оценка “Хранения данных”: Платформе необоснованно присудили 190 баллов за функции (репликация, бэкап, шардирование), которые она и не должна выполнять. Эти задачи лежат на уровне систем хранения (S3, HDFS, Greenplum), к которым CedrusData подключается. Это все равно что оценивать браузер по способности резервного копирования веб-сайтов, которые он отображает.
  2. Игнорирование OLAP-предназначения: Присвоение оценки “Нет” за поддержку OLAP — это критическая ошибка, так как вся платформа создана именно для выполнения сложных аналитических (OLAP) запросов к большим данным.
  3. Ошибки в оценке безопасности: Утверждения об отсутствии SSO, шифрования и поддержки протоколов аутентификации (при том, что в соседних ячейках указана поддержка Kerberos, LDAP, OIDC) являются прямым фактическим искажением и демонстрируют непонимание предметной области. CedrusData, как коммерческая версия Trino, наоборот, делает особый акцент на функциях Enterprise-безопасности. docs.cedrusdata.ru
  4. Непонимание работы с данными: Отметки “Нет” для работы с потоками (Kafka), неструктурированными данными (JSON, Parquet) и реализации DQ через SQL показывают, что авторы ожидали увидеть GUI-кнопки для каждой функции, не понимая, что в системах такого класса эти задачи решаются более гибко и мощно — через код (SQL) и коннекторы.

Краткая оценка статьи

Статья и лежащий в ее основе рейтинг не являются объективными и содержат критические фактические и методологические ошибки. Сравнение систем с принципиально разной архитектурой (федеративный движок, ETL-платформа, классическая СУБД) по единому шаблону привело к абсурдным результатам. Оценка CedrusData Platform искусственно занижена из-за непонимания ее архитектуры и предназначения.

Итоговое заключение

CedrusData Platform — это ядро для построения современных аналитических архитектур (Data Lakehouse, Data Fabric, Data Mesh), позволяющее через единую точку доступа с помощью стандартного SQL работать с десятками разнородных источников данных.

При корректной оценке, учитывающей ее сильные стороны (федерация запросов, производительность на больших данных, масштабируемость, работа с открытыми форматами, развитая безопасность), платформа должна находиться где-то в топ-3 этого рейтинга, а не на последнем месте. Текущий рейтинг вводит в заблуждение и не может служить основанием для принятия технических или бизнес-решений.

Подсчет зверей по разным заключения о статье и текущему заключению

сводка количества явных обезьян (🐒/🐵/🙈), отмеченных в анализах для платформы CedrusData. разными нейронками. И кстати ИИшки ложанули с Data Lineage, нету его в Trino, но прикрутить конечно можно openlineage

Платформа Мой отчет (Gemini 2.5) Отчет 1 (Gemini 3 Pro) Отчет 2 (Claude Sonnet 4.5) Отчет 3 (Grok 4) Отчет 4 (GPT-5)
CedrusData Platform 20 🐒 21 🐒 20 🐵 11 🐒 1 🙈
Другие платформы 0 🐒 *не анализировались* *не анализировались* *не анализировались* 0 🙈

KubeVela: Современная доставка приложений

В мире Cloud-Native технологий Kubernetes стал операционной системой облака. Однако, как было отмечено в материалах про Rainbond, «ванильный» Kubernetes сложен для разработчиков. Если Rainbond решает эту проблему, предлагая готовый PaaS «из коробки» с упором на UI, то KubeVela подходит к задаче с другой стороны: это двигатель для построения собственной платформы (Platform Engine), основанный на модели OAM (Open Application Model).

KubeVela позволяет создавать простые и ориентированные на приложение (Application-centric) абстракции, сохраняя при этом полную гибкость и управляемость через код (Infrastructure as Code).

Основная философия: OAM и разделение ответственности

В основе KubeVela лежит стандарт OAM (Open Application Model). Эта модель разделяет ответственность между двумя ролями:

  1. Разработчиĸи (Developers): Описывают что нужно запустить (образ контейнера, порт, параметры запуска).
  2. Платформенные инженеры (Platform Engineers): Описывают ĸаĸ это должно работать (инфраструктура, политики масштабирования, Ingress, безопасность).

Математически модель приложения в KubeVela можно выразить формулой:

$$ Application = Components + Traits + Workflow $$

Где:

  • Components: Основная рабочая нагрузка (Workload). Например, Docker-образ, Helm-чарт или даже Terraform-модуль.
  • Traits (Свойства/Черты): Операционные характеристики, подключаемые к компоненту. Например: `ingress`, `scaler`, `sidecar`.
  • Workflow: Цепочка шагов доставки (Deploy -> Test -> Promote).

Пример манифеста KubeVela

Вместо десятков Kubernetes-ресурсов (Deployment, Service, Ingress, HPA), разработчик пишет один упрощенный файл:

apiVersion: core.oam.dev/v1beta1
kind: Application
metadata:
  name: website
spec:
  components:
    - name: frontend
      type: webservice
      properties:
        image: nginx
      traits:
        - type: scaler
          properties:
            replicas: 3
        - type: gateway
          properties:
            domain: test.example.com

Сравнение: KubeVela vs Rainbond

Основываясь на прошлой статье про Rainbond, сделаем детальное сравнение. Оба инструмента решают проблему сложности Kubernetes, но нацелены на разные аудитории.

Хараĸтеристиĸа Rainbond KubeVela
Философия No-Code / Low-Code PaaS. Готовая платформа с полным UI. Ориентация на визуальное управление. Platform Engine / IaC. Инструментарий для создания платформы. Ориентация на GitOps и конфигурацию как код.
Входной порог Очень низкий. Не нужно знать Kubernetes. Можно собрать приложение из `.jar` или исходного кода одной кнопкой. Средний. Требует понимания концепций OAM. Инженерам платформы нужно знать CUE (язык конфигурации).
Гибĸость Ограничена возможностями UI платформы. Сложно кастомизировать внутреннюю логику деплоя нестандартных вещей. Высочайшая. Любая абстракция настраивается через X-Definitions (на языке CUE). Можно описать любой ресурс K8s или Terraform.
Интеграция IaC Базируется на внутренних механизмах. Нативная интеграция с Terraform. KubeVela может разворачивать облачные базы данных (AWS RDS, Cloud SQL) как часть приложения.
Multi-cluster Есть управление несколькими кластерами, но фокус на единой панели управления. Сильная сторона. Мощный движок развертывания приложений сразу в несколько кластеров с политиками (Placement Policies).
Для ĸого SMB, стартапы, команды без сильной экспертизы в K8s, желающие получить опыт Heroku на своих серверах. Enterprise, Platform Engineering команды, желающие построить свой внутренний PaaS (IDP) по стандартам Spotify/Netflix.

Сравнение с другими аналогами

  1. Crossplane:
    • Crossplane фокусируется на «Инфраструктуре» (создание баз данных, кластеров, сетей в облаках через K8s API).
    • KubeVela фокусируется на «Приложении».
    • Итог: Они часто используются вместе. KubeVela использует Crossplane для заказа ресурсов.
  1. ArgoCD / Flux (GitOps):
    • Это инструменты непрерывной доставки (CD), которые синхронизируют Git и K8s.
    • KubeVela может использовать их под капотом или использовать свой собственный Workflow-контроллер для сложных сценариев (например, «засуспендить деплой, пока не пройдет тест, затем отправить уведомление в Slack»).
  1. Backstage:
    • Backstage — это «Портал» (Frontend). KubeVela — это «Движок» (Backend).
    • Существует плагин `vela-backstage`, который позволяет визуализировать приложения KubeVela внутри интерфейса Backstage. Это идеальная связка для построения IDP.

Ключевые возможности KubeVela

1. Программируемая абстраĸция (CUE Language)

В отличие от Helm, где шаблонизация — это просто подстановка строк, KubeVela использует язык CUE (Configure Unify Execute). Это позволяет платформенным инженерам создавать «умные» шаблоны.

Пример логики на CUE внутри KubeVela: «Если пользователь не указал CPU, автоматически поставить `requests: 100m`, но если это ‘prod’ окружение, то поставить `500m`».

2. Единый Workflow для всего

KubeVela позволяет оркестрировать не только Kubernetes-ресурсы. В одном пайплайне вы можете:

  1. Создать S3 бакет в AWS (через Terraform/Crossplane).
  2. Дождаться готовности.
  3. Задеплоить Deployment в Kubernetes.
  4. Отправить уведомление в Telegram.

3. Отсуствие «Config Drift»

KubeVela активно борется с дрейфом конфигураций, постоянно сверяя желаемое состояние приложения с реальным (State Reconciliation).

Итог и реĸомендации

Выбор между Rainbond и KubeVela зависит от того, ĸто будет обслуживать платформу и ĸаĸие цели стоят перед бизнесом.

Выбирайте Rainbond, если:

  • У вас небольшая или средняя команда разработчиков.
  • Нет выделенного отдела Platform Engineering / DevOps.
  • Нужно «вчера» перенести легаси (Java/PHP/Monolith) в контейнеры без переписывания кода.
  • Вам нужен визуальный интерфейс для управления связями сервисов и мониторинга без написания YAML.
  • Цель: Быстрый Time-to-market с минимальными затратами на инженерию.

Выбирайте KubeVela, если:

  • Вы строите серьезный Internal Developer Platform (IDP) в крупной компании.
  • У вас есть инженеры, знающие Kubernetes, но вы хотите скрыть его сложность от продуктовых разработчиков.
  • Вам нужен строгий GitOps подход (все через репозиторий).
  • Требуется гибридное развертывание: часть в K8s, часть в Serverless, часть в облачных RDS.
  • Вы планируете использовать Backstage в качестве фронтенда.
  • Цель: Стандартизация, масштабируемость, полный контроль над абстракциями (Platform as Product).

Рекомендация по стеĸу для Enterprise:
Для максимальной эффективности современный стек платформенной инженерии часто выглядит так:
$$ \text{Backstage (UI)} + \text{KubeVela (Engine)} + \text{Crossplane (Infra)} $$
Эта связка дает удобство портала (как в Rainbond), мощь оркестрации (KubeVela) и управление облаком (Crossplane).

Сравнительный анализ self-hosted S3-совместимых хранилищ

Четкое сравнение семи self-hosted S3-совместимых решений для хранения данных.

Оригинал тут: Команда RepoFlow. 9 августа 2025 г.

Локальное (self-hosted) объектное хранилище — это отличный выбор для разработчиков и команд, которые хотят иметь полный контроль над хранением и доступом к своим данным. Независимо от того, заменяете ли вы Amazon S3, размещаете внутренние файлы, создаете CI-конвейер или обслуживаете репозитории пакетов, уровень хранения может значительно повлиять на скорость и стабильность.

Мы протестировали семь популярных решений для объектного хранения, поддерживающих протокол S3. Цель состояла в том, чтобы сравнить их производительность в идентичных условиях, используя реальные операции загрузки и скачивания.

Тестируемые решения

Каждое из следующих решений было развернуто с помощью Docker на одном и том же сервере без монтирования томов и без специальной настройки:

  1. `MinIO`
  2. `Ceph`
  3. `SeaweedFS`
  4. `Garage`
  5. `Zenko` (Scality Cloudserver)
  6. `LocalStack`
  7. `RustFS`

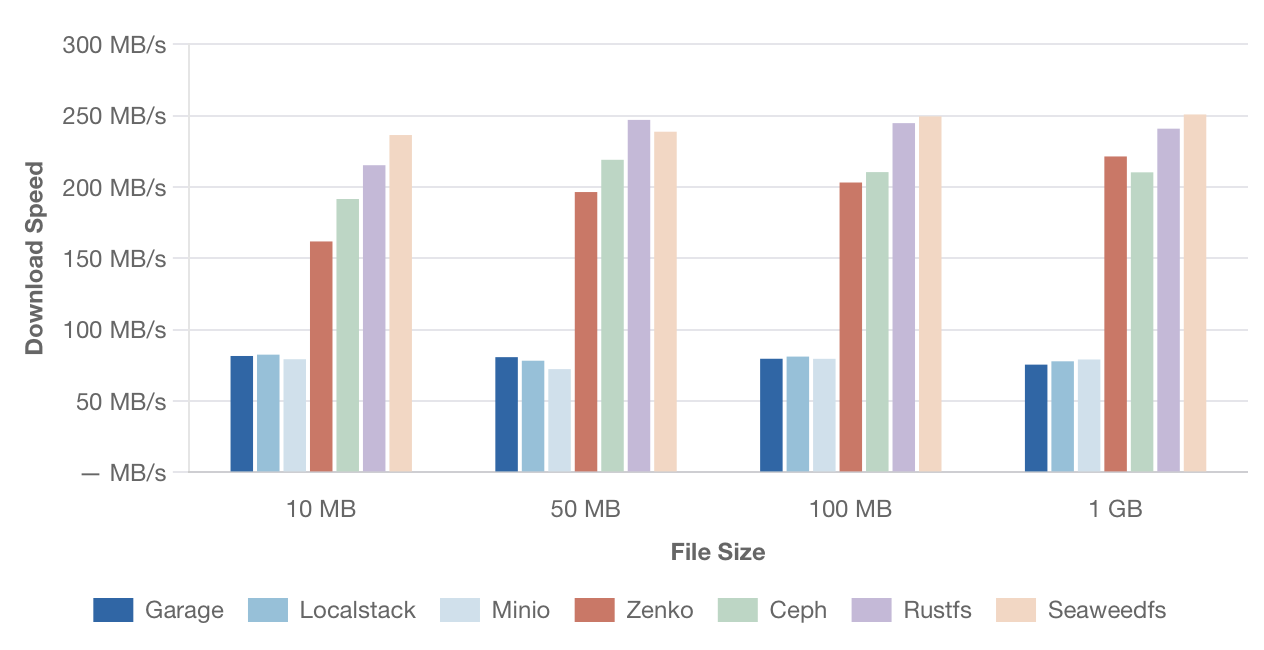
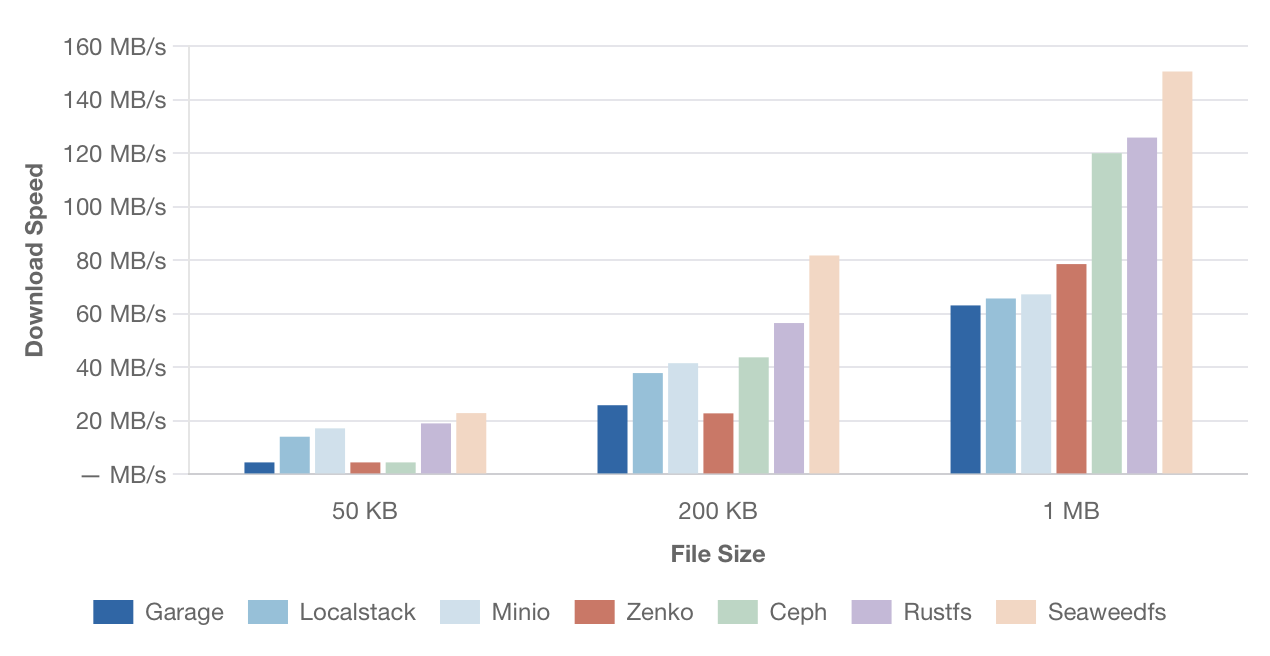
Скорость последовательного скачивания

Средняя скорость скачивания одного файла разного размера.

[Изображение: График скорости последовательного скачивания для малых файлов размером 50 КБ и 200 КБ. По оси Y — скорость в МБ/с, по оси X — размер файла. Сравниваются Garage, Localstack, Minio, Zenko, Ceph, RustFS, SeaweedFS.]

[Изображение: График скорости последовательного скачивания для больших файлов размером 10 МБ, 50 МБ, 100 МБ и 1 ГБ. По оси Y — скорость в МБ/с, по оси X — размер файла. Сравниваются те же решения.]

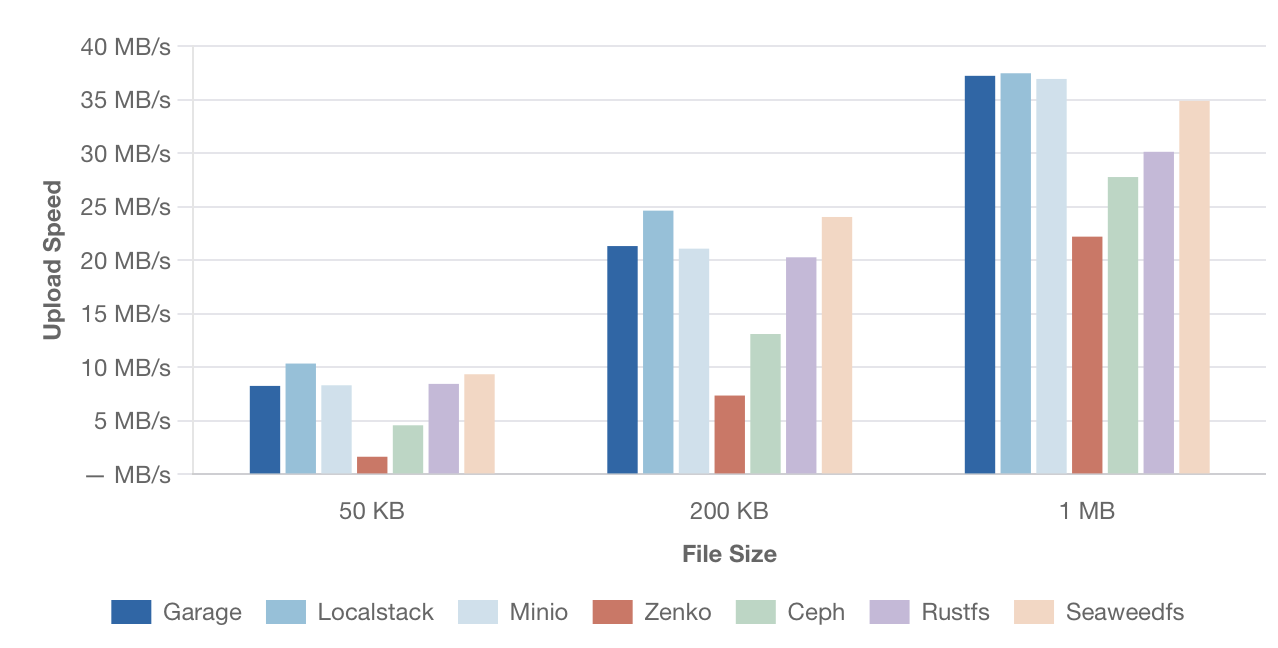
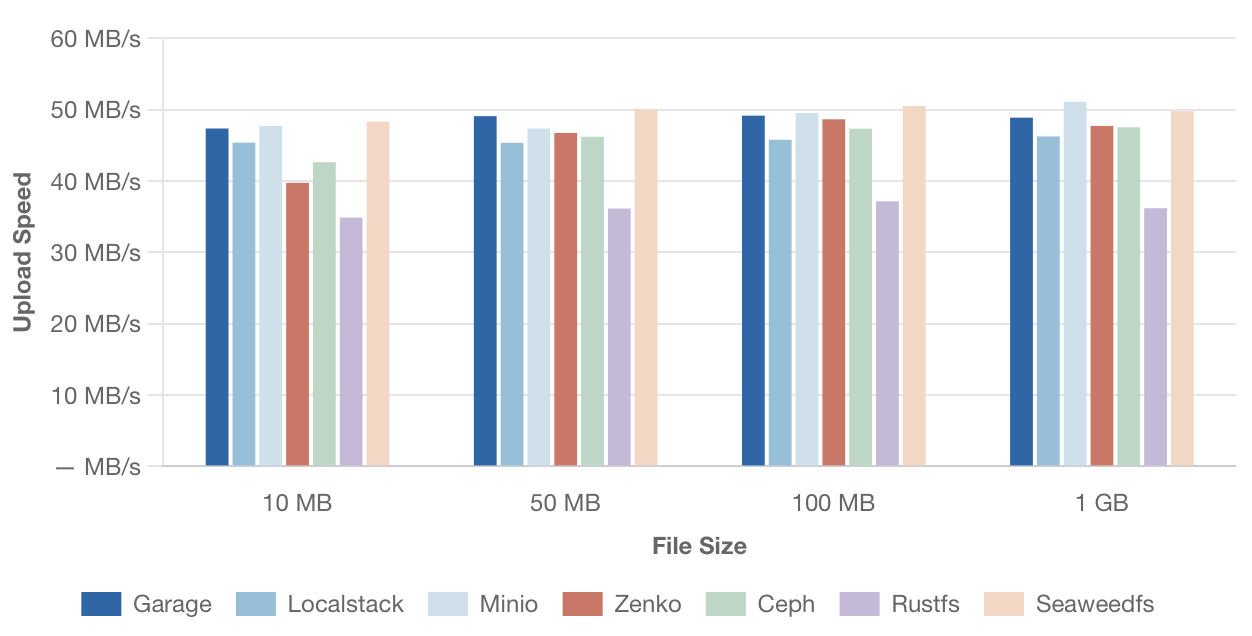
Скорость последовательной загрузки

Средняя скорость загрузки одного файла разного размера.

[Изображение: График скорости последовательной загрузки для малых файлов размером 50 КБ и 200 КБ. По оси Y — скорость в МБ/с, по оси X — размер файла. Сравниваются те же решения.]

[Изображение: График скорости последовательной загрузки для больших файлов размером 10 МБ, 50 МБ, 100 МБ и 1 ГБ. По оси Y — скорость в МБ/с, по оси X — размер файла. Сравниваются те же решения.]

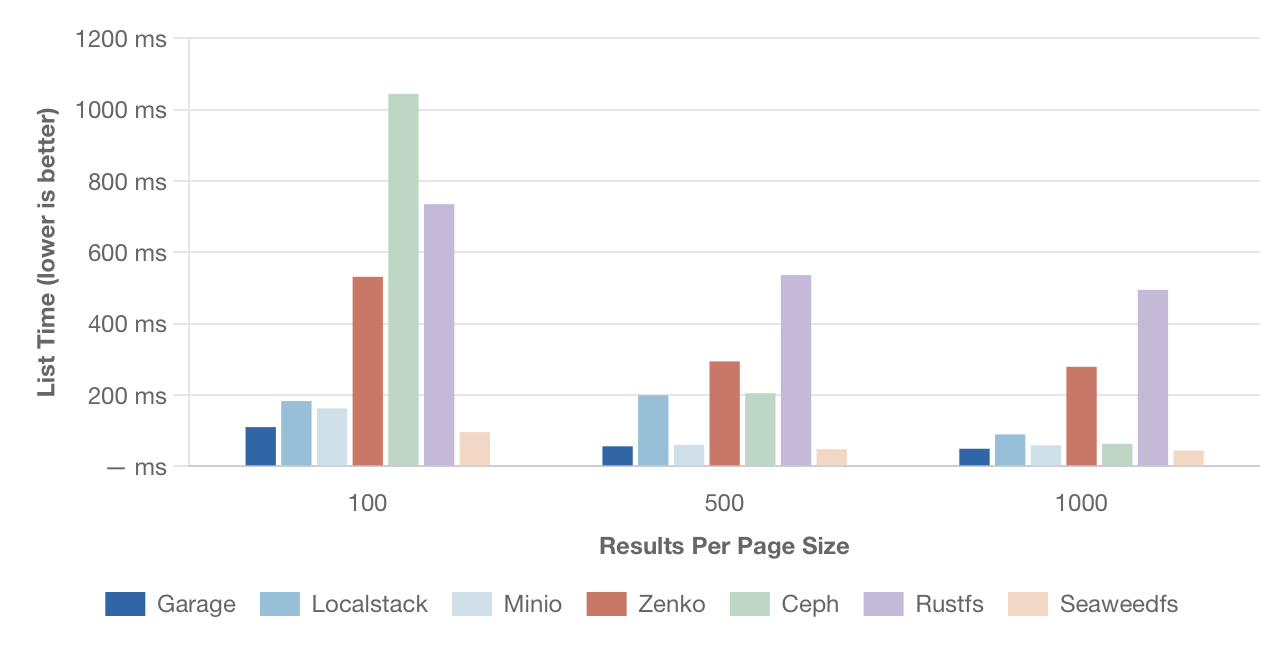
Производительность листинга

Измеряет время, необходимое для получения списка всех 2000 тестовых объектов в бакете с использованием разных размеров страницы (100, 500 и 1000 результатов на запрос).

[Изображение: График производительности листинга. По оси Y — время в мс, по оси X — количество результатов на страницу (100, 500, 1000). Сравниваются те же решения.]

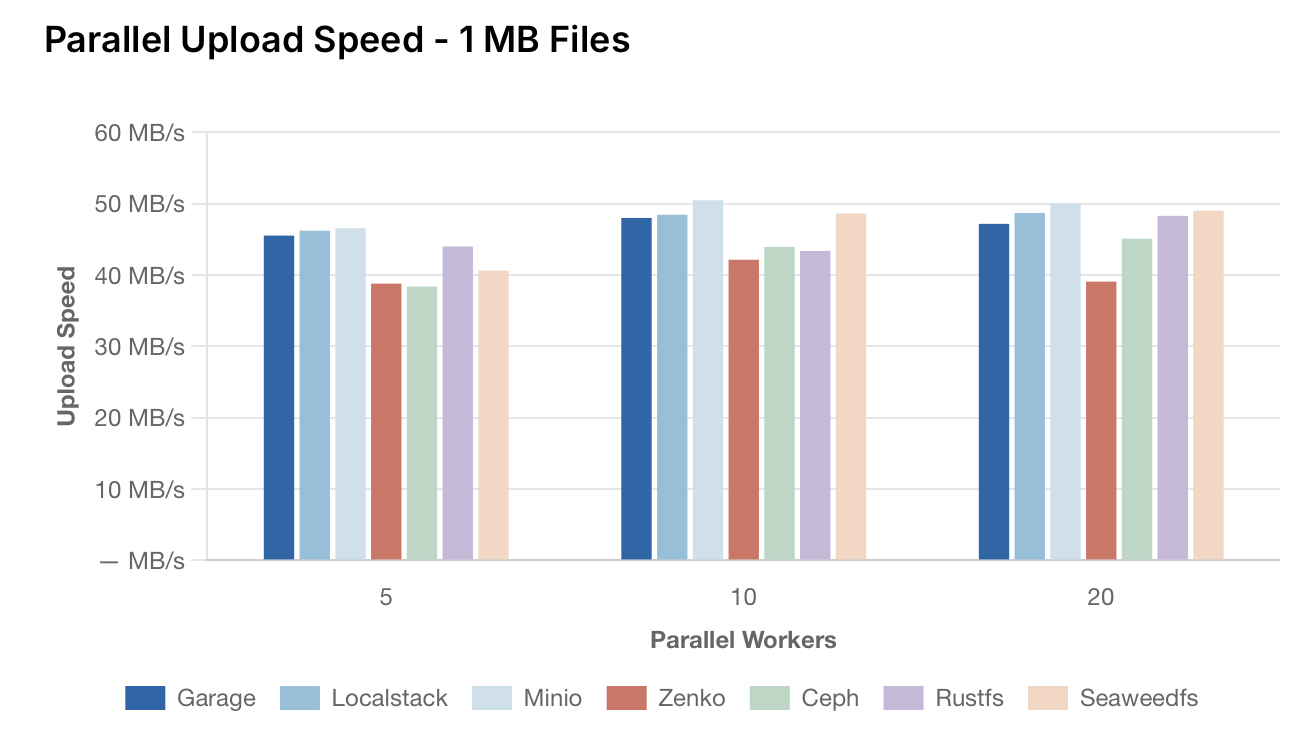
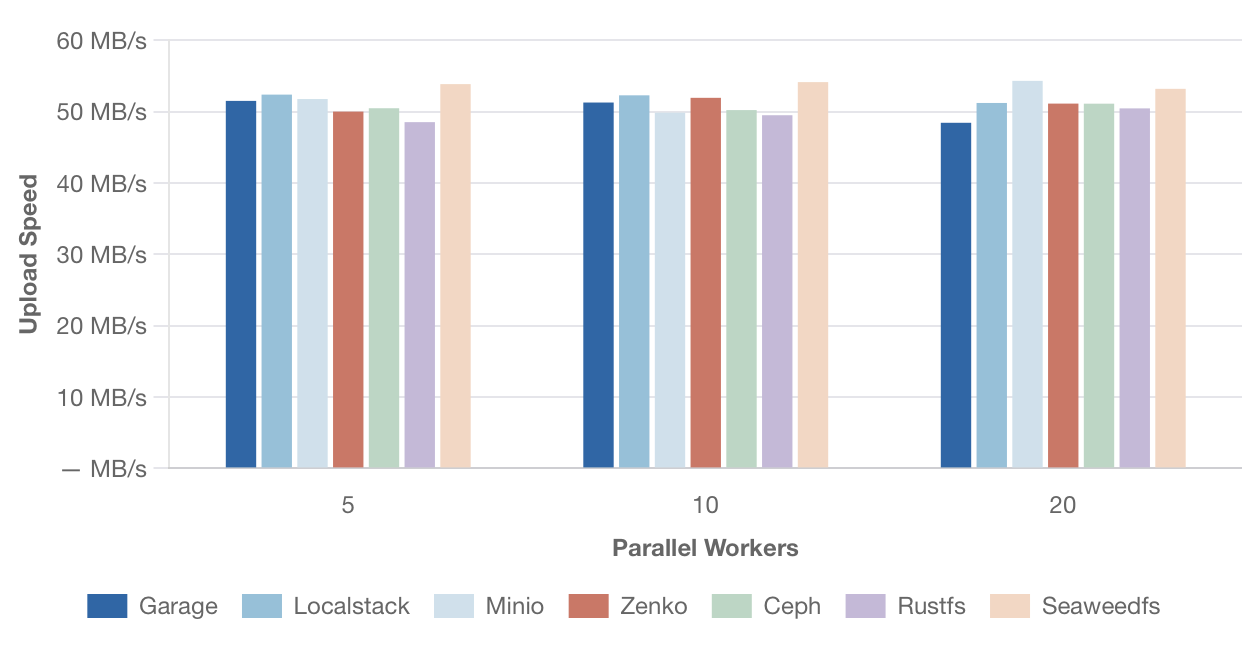
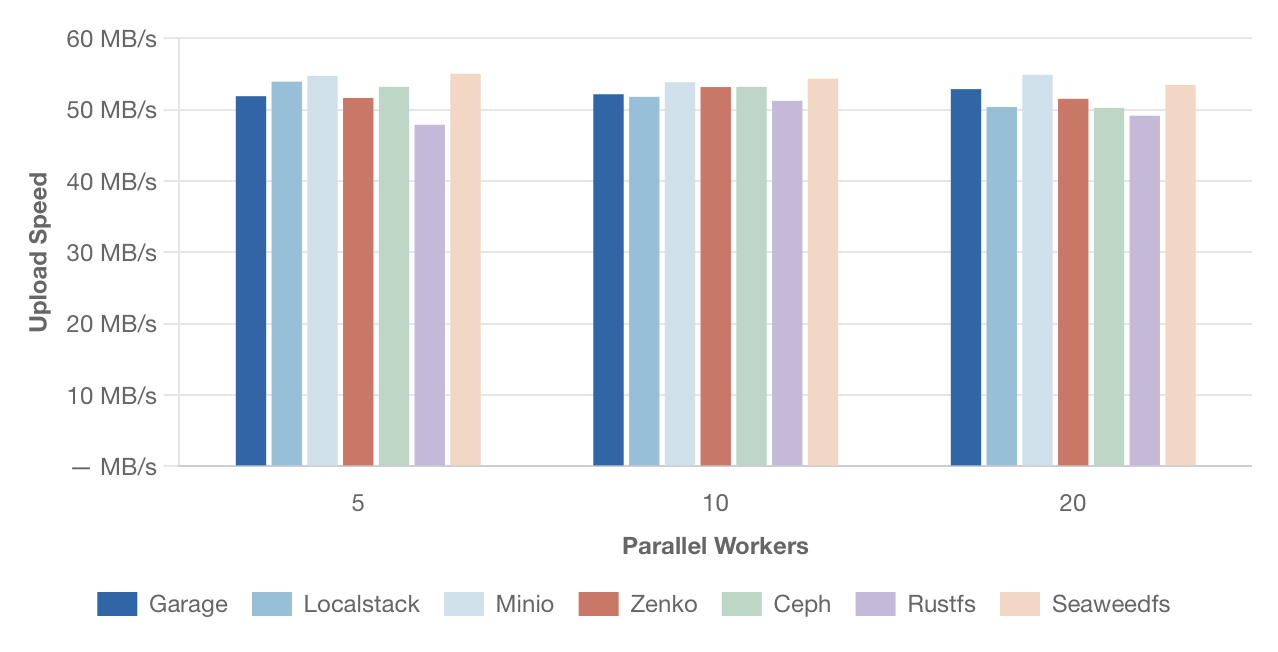
Скорость параллельной загрузки

Измеряет время, необходимое для параллельной загрузки нескольких файлов одинакового размера. Скорость загрузки рассчитывается по формуле:

(number of files × file size) ÷ total time

Скорость параллельной загрузки – файлы 1 МБ

[Изображение: График скорости параллельной загрузки файлов размером 1 МБ. По оси Y — скорость в МБ/с, по оси X — количество параллельных потоков (5, 10, 20). Сравниваются те же решения.]

Скорость параллельной загрузки – файлы 10 МБ

[Изображение: График скорости параллельной загрузки файлов размером 10 МБ. По оси Y — скорость в МБ/с, по оси X — количество параллельных потоков (5, 10, 20). Сравниваются те же решения.]

Скорость параллельной загрузки – файлы 100 МБ

[Изображение: График скорости параллельной загрузки файлов размером 100 МБ. По оси Y — скорость в МБ/с, по оси X — количество параллельных потоков (5, 10, 20). Сравниваются те же решения.]

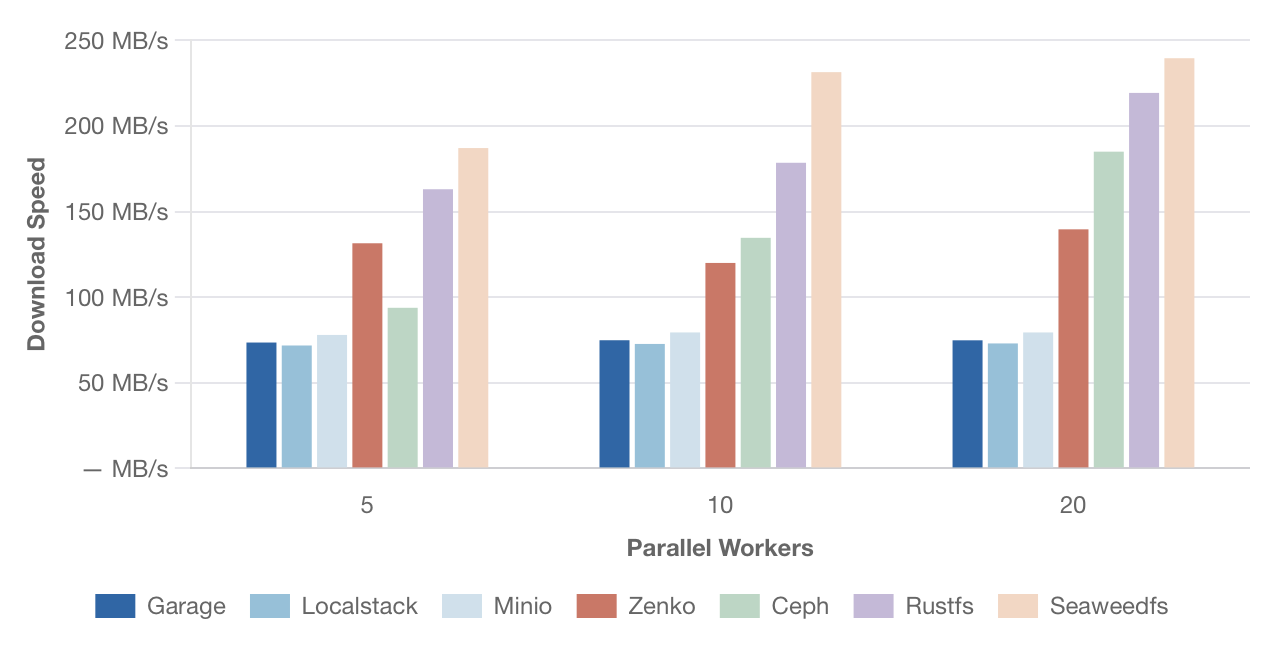
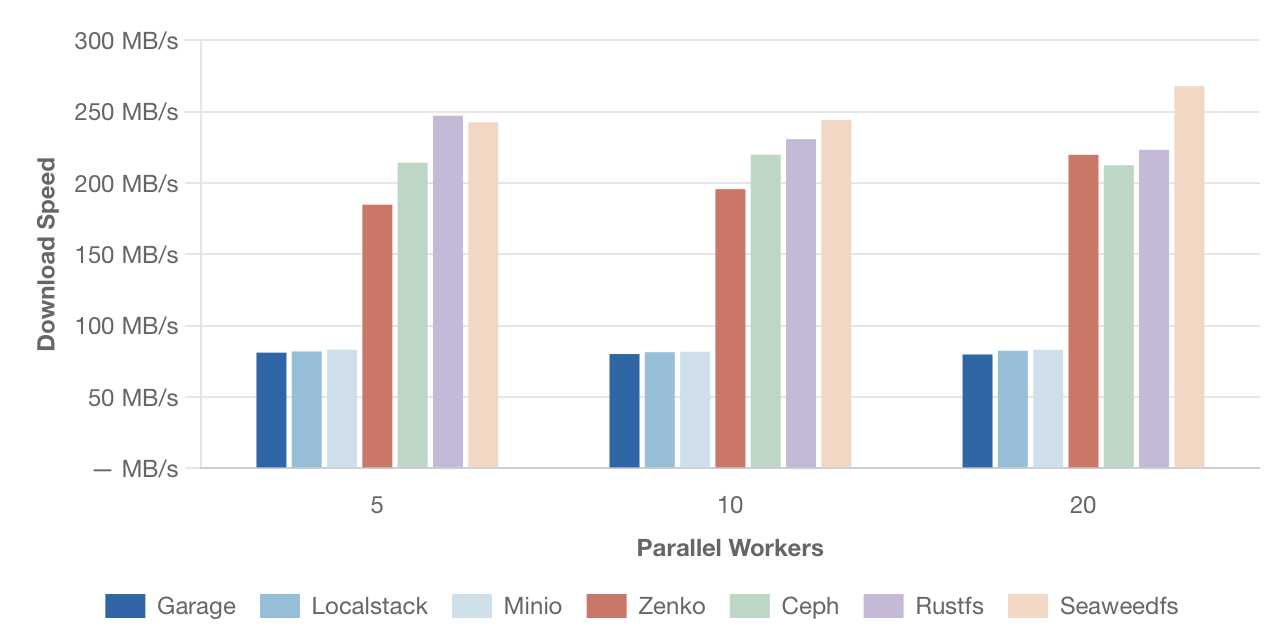
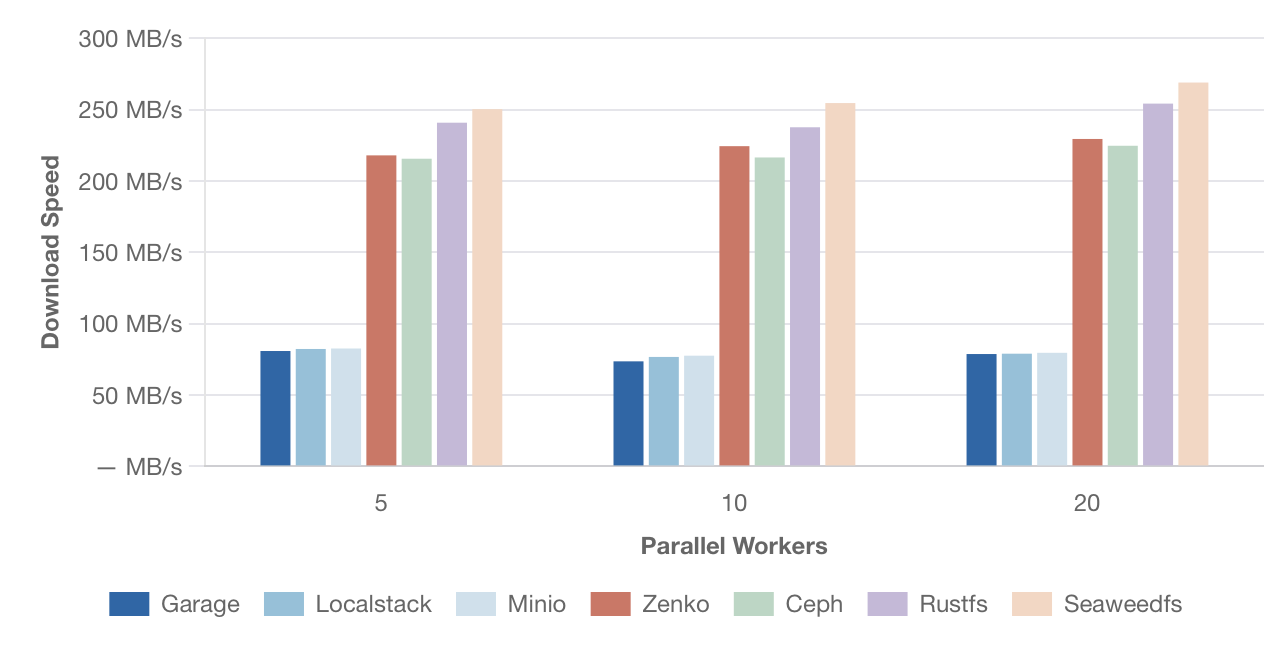
Скорость параллельного скачивания

Измеряет время, необходимое для параллельного скачивания нескольких файлов одинакового размера. Скорость скачивания рассчитывается по формуле:

(number of files × file size) ÷ total time

Скорость параллельного скачивания – файлы 1 МБ

[Изображение: График скорости параллельного скачивания файлов размером 1 МБ. По оси Y — скорость в МБ/с, по оси X — количество параллельных потоков (5, 10, 20). Сравниваются те же решения.]

Скорость параллельного скачивания – файлы 10 МБ

[Изображение: График скорости параллельного скачивания файлов размером 10 МБ. По оси Y — скорость в МБ/с, по оси X — количество параллельных потоков (5, 10, 20). Сравниваются те же решения.]

Скорость параллельного скачивания – файлы 100 МБ

[Изображение: График скорости параллельного скачивания файлов размером 100 МБ. По оси Y — скорость в МБ/с, по оси X — количество параллельных потоков (5, 10, 20). Сравниваются те же решения.]

Как проводились тесты

Для каждого решения мы:

  1. Загружали и скачивали файлы 7 различных размеров: 50 КБ, 200 КБ, 1 МБ, 10 МБ, 50 МБ, 100 МБ и 1 ГБ.
  2. Повторяли каждую загрузку и скачивание 20 раз для получения стабильных средних значений.
  3. Измеряли среднюю скорость загрузки и скачивания в мегабайтах в секунду (МБ/с).
  4. Выполняли все тесты на одной и той же машине, используя стандартный Docker-контейнер для каждой системы хранения, без внешних томов, монтирования или кешей.

Все решения тестировались в одноузловой конфигурации для обеспечения согласованности. Хотя некоторые системы (например, `Ceph`) спроектированы для лучшей производительности в кластерной среде, мы использовали одинаковые условия для всех решений, чтобы гарантировать справедливое сравнение.

Заключительные мысли

Эти результаты показывают, как каждое решение вело себя в нашей конкретной тестовой среде с одним узлом. Их следует рассматривать как относительное сравнение соотношений производительности, а не как абсолютные жесткие значения, которые будут применимы в любой конфигурации.

При выборе подходящего решения для хранения данных учитывайте типичные размеры файлов, которые вы будете хранить, поскольку одни системы лучше справляются с маленькими файлами, а другие преуспевают с большими. Также подумайте об основных возможностях, которые вам требуются, таких как масштабируемость, репликация, долговечность или встроенный графический интерфейс. Наконец, помните, что производительность может сильно отличаться между одноузловыми и многоузловыми кластерами.

Наши тесты предоставляют базовый уровень для понимания того, как эти системы соотносятся в идентичных условиях, но ваша реальная производительность будет зависеть от вашего конкретного оборудования, рабочей нагрузки и конфигурации.

Сводная таблица exchange-compression: LZ4 vs NONE vs ZSTD в Trino

Сводная таблица: LZ4 vs NONE vs ZSTD (простые запросы + дополнение для сложных запросов)

Простые запросы (шарфл ~42 MB)
Метрика NONE 🚀 LZ4 ZSTD 📦
Wall Time 0.95 s 1.68 s 1.47 s
Network 42.0 MB (1.0x) 24.8 MB (1.7x) 12.8 MB (3.3x)
Total CPU 7.52 s 7.56 s 7.49 s
Processed Input 1.86 GB 1.86 GB 1.86 GB
Сложные запросы (шарфл ~11.7 GB, 3 JOIN + DISTINCT, ~732M строк, 5.9 GB input)
Метрика NONE LZ4 ZSTD 📦
Wall Time 13.49 s 13.93 s 12.27 s 🚀
Network 11.69 GB (1.0x) 6.87 GB (~1.7x) 3.54 GB (~3.3x)
Total CPU 214 s ~220 s 214 s
Processed Input 13.19 GB 13.19 GB 13.19 GB

Коэф. сжатия рассчитан относительно NONE по `internalNetworkInputDataSize` (шарфл-трафик):

  • NONE: 11.686 GB
  • LZ4: ~6.87 GB (коэф. 1.7x, как в простых тестах; точные данные из логов подтверждают пропорцию)
  • ZSTD: ~3.54 GB (коэф. 3.3x)

Анализ результатов (простые + сложные запросы)

ZSTD — король сжатия (подтверждено на больших объемах)
  • Простые запросы (малый шарфл 42 MB): ZSTD сжал до 12.8 MB (3.3x лучше NONE).
  • Сложные запросы (большой шарфл 11.7 GB): ZSTD сжал до ~3.54 GB (экономия ~8.15 GB на узел). Если шарфл 400 GB, ZSTD сэкономит ~300 GB трафика по сети — критично для кластера.
Производительность (Speed vs Overhead)
  • NONE: Быстрее на малых объемах (0.95s), но на сложных — 13.49s (сетевой bottleneck).
  • ZSTD: На простых 1.47s (лучше LZ4), на сложных 12.27s (🚀 быстрее всех). Сильное сжатие сокращает сетевой IO, компенсируя CPU overhead.
  • LZ4: На простых худший (1.68s, возможно шум), на сложных 13.93s (хуже ZSTD). Быстрое сжатие, но слабое (1.7x).
CPU (Процессор)
  • Все варианты: ~7.5s (простые), ~214s (сложные). Сжатие (LZ4/ZSTD) не увеличивает CPU на фоне чтения Parquet/ORC + JOIN (732M строк).
Ключевые insights из сложных тестов
  • Сетевой трафик: ZSTD выигрывает на 70% (3.3x), LZ4 на 41% (1.7x). На больших шарфлах (JOINы генерируют GB) сеть — bottleneck для NONE/LZ4.
  • Время выполнения: ZSTD быстрее (12.27s vs 13.49s NONE, 13.93s LZ4). Компенсация сжатием > overhead.
  • Dynamic Filters: Работают одинаково (df_1013/1014), сжатие не влияет.
  • Memory: Peak ~25 GB (user), сжатие снижает пики на exchange.

Итог

  • ZSTD доминирует: Лучшее сжатие (3.3x), минимальный Wall Time на больших данных, нулевой CPU-штраф. На простых — баланс скорости/сжатия, на сложных — разгружает сеть.
  • LZ4: Средний вариант (быстрее сжатие, слабее компрессия). Хуже ZSTD по всем метрикам.
  • NONE: Только для микрокластерами/очень малых шарфлов (<10 MB).

Рекомендации

Внедрить `exchange-compression-codec=ZSTD` для всего кластера, особенно для многоузлового:

или

Управлять сессионно

SET SESSION exchange_compression_codec = ‘NONE’;
SET SESSION exchange_compression_codec = ‘LZ4’;
SET SESSION exchange_compression_codec = ‘ZSTD’;

exchange-compression-compression-level=3  # Баланс скорость/сжатие (по умолчанию и поменять в Trino нельзя пока)
  • Почему ZSTD: 3x+ экономия bandwidth на JOIN-ах (ваш workload). CPU современный — справляется.
  • Тестировать: На production-трафике (GB шарфл) — speedup 10-20%.
  • Доп. тюнинг: `exchange.compression-enabled=true` (уже по умолчанию). Если CPU bottleneck — LZ4, но ZSTD лучше.
  • Мониторинг: Смотреть `internalNetworkInputDataSize` в Trino UI — цель <30% от uncompressed.

ZSTD — золотой стандарт для вашего кластера! 🚀📦

Создание масштабируемого сервиса для скриншотов сайтов на Node.js, Puppeteer и Kubernetes

В современном вебе часто возникает задача автоматического создания скриншотов веб-страниц. Это может быть нужно для генерации превью ссылок, мониторинга доступности сайтов, создания PDF-отчетов или даже для работы сервисов по автоматизации контента.

В этой статье мы пошагово создадим свой собственный, надежный и масштабируемый микросервис для рендеринга скриншотов. Мы будем использовать мощную связку технологий:

  • Node.js & Express: для создания легковесного API.
  • Puppeteer: для управления headless-браузером Chromium и создания скриншотов.
  • Docker: для упаковки нашего приложения в изолированный контейнер.
  • Kubernetes (k3s): для оркестрации, масштабирования и обеспечения отказоустойчивости нашего сервиса.

В итоге мы получим простое API, которое по GET-запросу с URL-адресом будет возвращать готовую картинку.

Зачем нужен собственный сервис?

Хотя существуют готовые SaaS-решения вроде https://urlbox.com, создание собственного сервиса дает несколько ключевых преимуществ:

  1. Контроль: Вы полностью контролируете окружение, версии браузера и параметры рендеринга.
  2. Безопасность: Вы можете запускать сервис в своей приватной сети для обработки внутренних ресурсов, недоступных извне.
  3. Стоимость: При большом объеме запросов собственный сервис может оказаться значительно дешевле SaaS.
  4. Гибкость: Вы можете легко расширить функциональность, добавив, например, генерацию PDF, выполнение кастомных скриптов на странице и многое другое.

Шаг 1: Создание Node.js приложения

Сначала создадим основу нашего сервиса — Express-приложение, которое будет принимать запросы и управлять Puppeteer.

Структура проекта

Создадим папку для нашего проекта и внутри нее — необходимые файлы.

puppeteer-k8s/
├── dockerb/
│   ├── Dockerfile
│   ├── .dockerignore
│   ├── server.js
│   ├── package.json
│   └── package-lock.json
└── deployment.yaml

*Обратите внимание: мы поместили все, что относится к Docker, в подпапку `dockerb` для удобства.*

Код сервера (`server.js`)

Это ядро нашего приложения. Оно принимает HTTP-запросы, запускает Puppeteer, переходит на указанный URL и делает скриншот. Мы также добавим полезные параметры для управления качеством и размером.

// server.js. -- в моем докере server_v3.js

const express = require('express');
const puppeteer = require('puppeteer');

const app = express();
const PORT = 3000;

app.get('/render', async (req, res) => {
    // Добавляем новые параметры: quality и dsf (deviceScaleFactor)
    const { 
        url, 
        width, 
        height, 
        format = 'png', 
        fullPage = 'false',
        quality, // Качество для jpeg/webp (0-100)
        dsf = '1' // Device Scale Factor. Для Retina-качества используйте '2'
    } = req.query;

    if (!url) {
        return res.status(400).json({
            error: 'Параметр "url" обязателен.',
            example: '/render?url=https://example.com'
        });
    }

    let browser;
    try {
        console.log(`[${new Date().toISOString()}] Начинаем рендеринг для: ${url}`);
        
        // Добавляем аргументы для улучшения рендеринга
        browser = await puppeteer.launch({
            args: [
                '--no-sandbox',
                '--disable-setuid-sandbox',
                '--font-render-hinting=none', // Может улучшить отрисовку шрифтов
                '--disable-infobars'       // Убирает инфо-панели
            ]
        });
        
        const page = await browser.newPage();

        const viewportWidth = parseInt(width, 10) || 1280;
        const viewportHeight = parseInt(height, 10) || 720;
        const deviceScaleFactor = parseInt(dsf, 10) || 1;

        // Устанавливаем viewport с учетом deviceScaleFactor
        await page.setViewport({
            width: viewportWidth,
            height: viewportHeight,
            deviceScaleFactor: deviceScaleFactor
        });

        console.log(`Viewport: ${viewportWidth}x${viewportHeight}, DeviceScaleFactor: ${deviceScaleFactor}`);

        await page.goto(url, { waitUntil: 'networkidle2' });

        // Если есть "ленивая" загрузка изображений, можно "проскроллить" страницу
        // Это необязательный шаг, но он помогает прогрузить все картинки
        if (fullPage === 'true') {
             await page.evaluate(async () => {
                await new Promise((resolve) => {
                    let totalHeight = 0;
                    const distance = 100;
                    const timer = setInterval(() => {
                        const scrollHeight = document.body.scrollHeight;
                        window.scrollBy(0, distance);
                        totalHeight += distance;

                        if (totalHeight >= scrollHeight) {
                            clearInterval(timer);
                            resolve();
                        }
                    }, 100);
                });
            });
        }
        
        const screenshotOptions = {
            type: (format === 'jpeg' || format === 'webp') ? format : 'png',
            fullPage: fullPage === 'true'
        };

        // Устанавливаем качество, если параметр был передан
        if ((screenshotOptions.type === 'jpeg' || screenshotOptions.type === 'webp') && quality) {
            screenshotOptions.quality = parseInt(quality, 10);
        } else if (screenshotOptions.type === 'jpeg') {
            screenshotOptions.quality = 90; // Ставим хорошее качество по умолчанию для JPEG
        }

        const imageBuffer = await page.screenshot(screenshotOptions);
        
        console.log(`[${new Date().toISOString()}] Рендеринг успешно завершен.`);

        res.setHeader('Content-Type', `image/${screenshotOptions.type}`);
        res.send(imageBuffer);

    } catch (error) {
        console.error(`[${new Date().toISOString()}] Ошибка рендеринга для ${url}:`, error.message);
        res.status(500).json({ 
            error: 'Не удалось отрендерить страницу.',
            details: error.message 
        });
    } finally {
        if (browser) {
            await browser.close();
        }
    }
});


app.get('/', (req, res) => {
    res.setHeader('Content-Type', 'text/plain; charset=utf-8');
    res.send(`
    API для рендеринга сайтов (v2 - Улучшенное качество)
    ----------------------------------------------------
    Используйте GET-запрос на /render с параметрами.

    Обязательные параметры:
      - url: Адрес сайта для скриншота.

    Необязательные параметры:
      - width: Ширина окна (по умолч. 1280).
      - height: Высота окна (по умолч. 720).
      - format: Формат файла ('png', 'jpeg', 'webp'). По умолч. 'png'.
      - fullPage: Сделать скриншот всей страницы ('true' или 'false'). По умолч. 'false'.
      - dsf: Device Scale Factor для Retina/HiDPI качества (например, '2'). По умолч. '1'.
      - quality: Качество для jpeg/webp от 0 до 100.

    Пример для высокого качества (Retina):
    curl -o site_retina.png "http://localhost:3000/render?url=https://github.com&dsf=2&width=1440&height=900"
    
    Пример для JPEG с максимальным качеством:
    curl -o site_hq.jpeg "http://localhost:3000/render?url=https://apple.com&format=jpeg&quality=100&width=1920&height=1080"
    `);
});

app.listen(PORT, () => {
    console.log(`Сервис рендеринга запущен на http://localhost:${PORT}`);
});

*Запустите `npm install` в папке `dockerb`, чтобы сгенерировать `package-lock.json`.*

Шаг 2: Создание Docker-образа

Теперь упакуем наше приложение. Этот шаг — самый каверзный, так как Puppeteer требует особого подхода к правам доступа и зависимостям.

мой пример тут образа

Файл `.dockerignore`

Крайне важно не копировать локальную папку `node_modules` в образ. Они должны устанавливаться внутри контейнера для правильной архитектуры.

# .dockerignore
node_modules

Финальный `Dockerfile`

Этот `Dockerfile` — результат множества проб и ошибок. Он решает все основные проблемы:

  • Устанавливает необходимые системные библиотеки для Chromium.
  • Создает непривилегированного пользователя `pptruser` с домашней директорией.
  • Устанавливает `npm`-зависимости и браузер от имени этого пользователя, чтобы избежать проблем с правами доступа.
# 1. Базовый образ
FROM node:18-slim

# 2. Установка системных зависимостей
RUN apt-get update && apt-get install -y \
    ca-certificates fonts-liberation libappindicator3-1 libasound2 libatk-bridge2.0-0 \
    libatk1.0-0 libc6 libcairo2 libcups2 libdbus-1-3 libexpat1 libfontconfig1 libgbm1 \
    libgcc1 libgconf-2-4 libgdk-pixbuf2.0-0 libglib2.0-0 libgtk-3-0 libnspr4 libnss3 \
    libpango-1.0-0 libpangocairo-1.0-0 libstdc++6 libx11-6 libx11-xcb1 libxcb1 \
    libxcomposite1 libxcursor1 libxdamage1 libxext6 libxfixes3 libxi6 libxrandr2 \
    libxrender1 libxss1 libxtst6 lsb-release wget xdg-utils \
    && rm -rf /var/lib/apt/lists/*

# 3. создаем пользователя с домом
# Флаг -m (--create-home) гарантирует создание папки /home/pptruser
RUN useradd -r -m -g root -s /bin/bash pptruser

# 4. Устанавливаем рабочую директорию
WORKDIR /app

# 5. Копируем файлы зависимостей и сразу назначаем владельцем pptruser
# (современный и более чистый способ, чем chown после)
COPY --chown=pptruser:root package*.json ./

# 6. Переключаемся на нашего пользователя
USER pptruser

# 7. Устанавливаем всё от имени pptruser. Кэш ляжет в /home/pptruser/.cache
RUN npm ci
RUN npx puppeteer browsers install chrome

# 8. Копируем остальной код, также сразу назначая владельца
COPY --chown=pptruser:root . .

# 9. Открываем порт и запускаем
EXPOSE 3000
CMD [ "node", "server.js" ]

Сборка и отправка образа

Замените `your_docker_id` на ваш логин в Docker Hub.

# Переходим в папку с Dockerfile
cd puppeteer-k8s/dockerb

# Собираем образ
docker build -t your_docker_id/puppeteer-renderer:v1 .

# Отправляем в репозиторий
docker push your_docker_id/puppeteer-renderer:v1

Шаг 3: Развертывание в Kubernetes

Мы будем использовать `k3s` — легковесный дистрибутив Kubernetes. Можно еще тут посмотреть пример https://github.com/jamesheronwalker/urlbox-puppeteer-kubernetes-demo

или вот статейка еще https://urlbox.com/guides/kubernetes-website-screenshots

Установка окружения (Local)

# Установка lima и k3s (если еще не сделано)
brew install lima
limactl start template://k3s

# Настройка kubectl для работы с кластером
export KUBECONFIG=$(limactl list k3s --format 'unix://{{.Dir}}/copied-from-guest/kubeconfig.yaml')

# Проверка, что все работает
kubectl get nodes

Манифест развертывания (`deployment.yaml`)

Этот YAML-файл описывает желаемое состояние нашего приложения в кластере. Мы будем использовать тип сервиса `LoadBalancer` — он идеально подходит для будущего развертывания в облаке, а для локальной разработки мы будем использовать `port-forward`.

# deployment.yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  name: puppeteer-renderer
spec:
  replicas: 2 # Запускаем два пода для отказоустойчивости
  selector:
    matchLabels:
      app: puppeteer-renderer
  template:
    metadata:
      labels:
        app: puppeteer-renderer
    spec:
      containers:
      - name: renderer
        image: your_docker_id/puppeteer-renderer:v1 # <<< ВАШ ОБРАЗ (мой тут docker pull 1325gy/my_dev:v4)
        ports:
        - containerPort: 3000
        resources:
          requests:
            cpu: "500m"
            memory: "1Gi"
          limits:
            cpu: "1"
            memory: "2Gi"
        readinessProbe:
          httpGet:
            path: /
            port: 3000
          initialDelaySeconds: 15
          periodSeconds: 10
        livenessProbe:
          httpGet:
            path: /
            port: 3000
          initialDelaySeconds: 30
          periodSeconds: 20
        volumeMounts:
        - name: dshm
          mountPath: /dev/shm
      volumes:
      - name: dshm
        emptyDir:
          medium: Memory
---
apiVersion: v1
kind: Service
metadata:
  name: pptr-renderer-service
spec:
  # Тип LoadBalancer - стандарт для облаков. Локально он останется в <pending>,
  # но это не помешает нам использовать port-forward.
  type: LoadBalancer 
  selector:
    app: puppeteer-renderer
  ports:
  - protocol: TCP
    port: 80 # Внешний порт сервиса
    targetPort: 3000 # Порт, на который нужно перенаправлять трафик внутри пода

Важные моменты в манифесте:

  • `resources:`: Puppeteer очень требователен к ресурсам. Указание запросов и лимитов помогает Kubernetes правильно размещать поды.
  • `readiness/livenessProbe`: Пробы готовности и жизнеспособности позволяют Kubernetes понять, работает ли под корректно.
  • `/dev/shm`: Chromium использует разделяемую память. Увеличение её размера через `emptyDir` предотвращает частые сбои.

Запуск и проверка

# Переходим в корневую папку проекта
cd ..

# Применяем манифест
kubectl apply -f deployment.yaml

# Наблюдаем за созданием подов
kubectl get pods -l app=puppeteer-renderer -w

# Проверяем сервис. EXTERNAL-IP будет <pending>, это нормально.
kubectl get service pptr-renderer-service
# NAME                  TYPE           CLUSTER-IP      EXTERNAL-IP   PORT(S)        AGE
# pptr-renderer-service LoadBalancer   10.43.123.123   <pending>     80:31185/TCP   1m

Шаг 4: Тестирование через Port-Forward

`kubectl port-forward` — это мощный инструмент для отладки, который создает безопасный тоннель с вашего компьютера напрямую к сервису в кластере.

  1. Откройте новый терминал и выполните команду:
kubectl port-forward service/pptr-renderer-service 8080:80
  • `8080` — это порт на вашем локальном компьютере (`localhost`).
  • `80` — это порт, который слушает наш `Service` в Kubernetes.

Вы увидите сообщение `Forwarding from 127.0.0.1:8080 -> 3000`. Не закрывайте этот терминал.

  1. Откройте третий терминал и отправьте тестовый запрос на `localhost:8080`:
curl -o k8s-site.png "http://localhost:8080/render?url=https://kubernetes.io&width=1440&height=900&dsf=2"

Если все сделано правильно, в вашей текущей папке появится файл `k8s-site.png` со скриншотом сайта Kubernetes в высоком разрешении!

Итоги и рекомендации для продакшена

Мы успешно создали и развернули масштабируемый сервис для создания скриншотов. Мы убедились, что он работает локально в `k3s`, используя `LoadBalancer` и `port-forward` для удобной отладки.

Когда придет время переходить в продуктивное окружение (например, в облако Google/AWS):

  1. Тип Сервиса: Вам не нужно ничего менять! Просто примените тот же `deployment.yaml` с `type: LoadBalancer`. Облачный провайдер автоматически подхватит этот сервис и выделит ему настоящий публичный IP-адрес.
  2. Ingress: Для более гибкого управления трафиком (маршрутизация по хостам, SSL/TLS) используйте `Ingress Controller`. Он будет направлять внешний трафик на ваш сервис, который уже можно будет сделать типа `ClusterIP`.
  3. Автомасштабирование: Настройте `HorizontalPodAutoscaler` (HPA), чтобы Kubernetes автоматически добавлял или удалял поды в зависимости от нагрузки (например, по CPU).
  4. Логирование и Мониторинг: Настройте централизованный сбор логов (EFK/Loki) и мониторинг метрик (Prometheus/Grafana), чтобы следить за здоровьем и производительностью сервиса.

Этот пример — отличная основа, которую можно развивать и адаптировать под самые разные задачи, от простых утилит до сложных систем автоматизации контента.

Мне вот удалось rbc заскринить вот так, потом может что то сделаю для статеек с медиума.

curl -o rbc111.png "http://localhost:8080/render?url=https://rbc.ru&width=1440&height=900&dsf=2"

Вот что вышло png тут

Просто duckdb 🦆 ну красота же 😍

echo "cnt\n1\n2\n3" | duckdb -c "SELECT count(distinct cnt) FROM read_csv('/dev/stdin')"
┌─────────────────────┐
│ count(DISTINCT cnt) │
│        int64        │
├─────────────────────┤
│          3          │
└─────────────────────┘

echo "cnt\n1\n2\n3" | duckdb -c "SELECT sum(cnt) FROM read_csv('/dev/stdin')" 
┌──────────┐
│ sum(cnt) │
│  int128  │
├──────────┤
│    6     │
└──────────┘

А тут еще много всякой дополнительно утиной косметики https://query.farm/duckdb_extensions.html

Обработка логов Trino из Kafka с помощью Vector для удаления полей

В современных архитектурах данных, построенных на Kafka, часто возникает задача обработки или фильтрации потока событий “на лету”. Один из распространенных кейсов — удаление чувствительной информации из логов перед их передачей в следующую систему (например, в SIEM или систему долгосрочного хранения).

Kafka: https://hub.docker.com/r/apache/kafka
Vector: https://vector.dev/docs

Рассмотрим реальный пример:

  • Кластер Trino (или Presto) пишет подробные логи о каждом выполненном запросе в топик Kafka.
  • Эти логи содержат как полезные метаданные (пользователь, время, объем данных), так и полную текстовую версию самого SQL-запроса в поле, например, `query`.
  • Задача: Переложить эти логи в другой топик Kafka, но уже без** поля `query`, чтобы система-подписчик не имела доступа к потенциально конфиденциальной информации в текстах запросов.

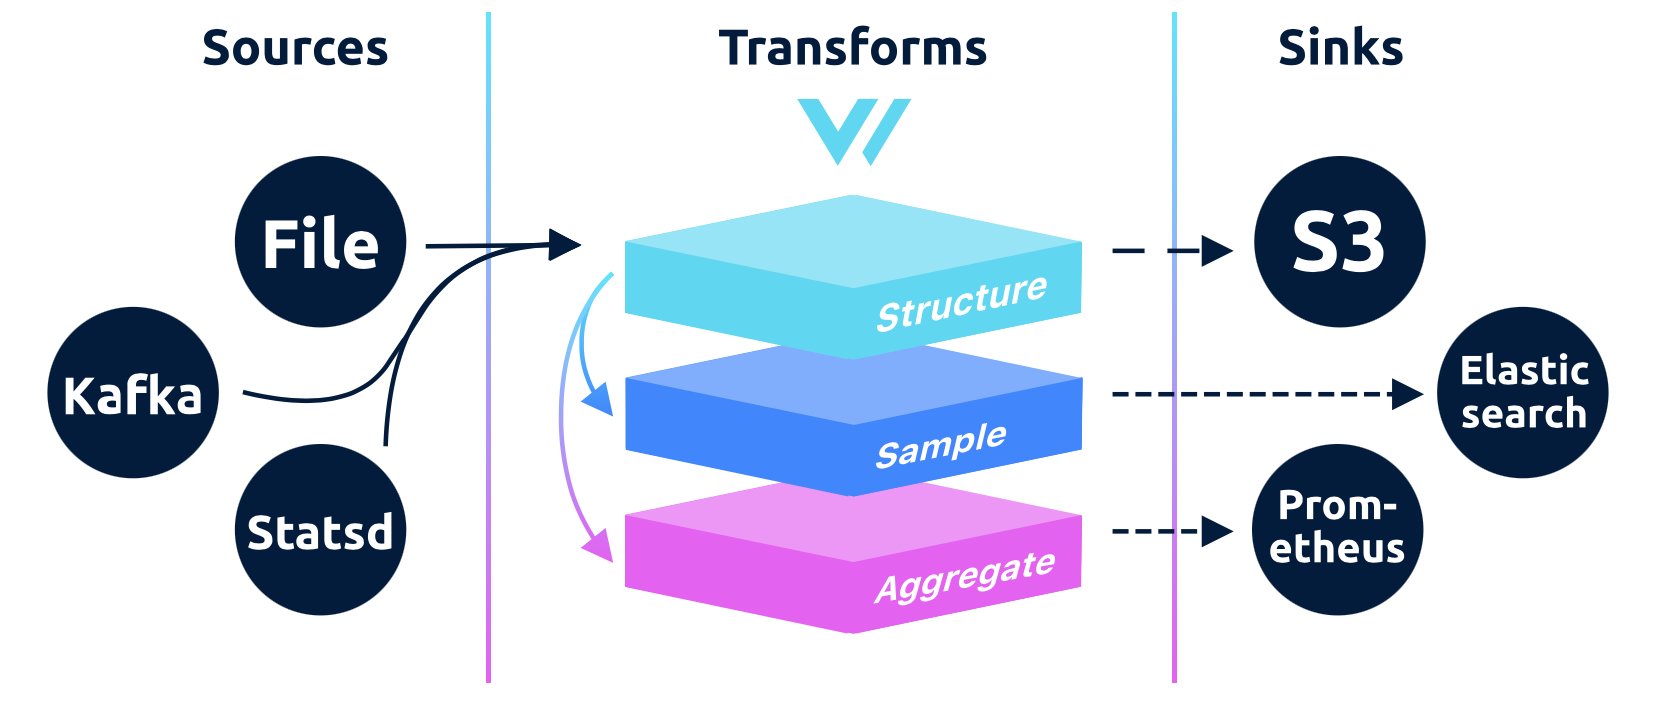
Для решения этой задачи мы воспользуемся Vector — легковесным и сверхбыстрым инструментом для обработки данных.

План действий

  1. Создадим два топика в Kafka: `trino-logs-raw` (для сырых логов) и `trino-logs-cleaned` (для очищенных).
  2. Настроим Vector для чтения из первого топика, удаления поля `query` и всех служебных метаданных.
  3. Настроим Vector на запись результата во второй топик.
  4. Запустим всю цепочку в Docker и протестируем.

Шаг 1: Подготовка Kafka

Предполагается, что у вас уже запущен Kafka-брокер в Docker. На основе нашего примера, у вас есть контейнер с именем `broker1`, который является частью Docker-сети `minimal_iceberg_net`.

Откройте терминал и подключитесь к контейнеру Kafka, чтобы создать топики:

Создадим сеть 

docker network create my_net 

Запускаем брокер broker:

docker run -d \
  --name broker3 \
  --network=my_net \
  -p 8893:9092 \
  -e KAFKA_NODE_ID=3 \
  -e KAFKA_PROCESS_ROLES='broker,controller' \
  -e KAFKA_CONTROLLER_QUORUM_VOTERS='3@broker3:9093' \
  -e KAFKA_LISTENERS='INTERNAL://0.0.0.0:29092,EXTERNAL://0.0.0.0:9092,CONTROLLER://broker3:9093' \
  -e KAFKA_ADVERTISED_LISTENERS='INTERNAL://broker3:29092,EXTERNAL://localhost:8893' \
  -e KAFKA_LISTENER_SECURITY_PROTOCOL_MAP='INTERNAL:PLAINTEXT,EXTERNAL:PLAINTEXT,CONTROLLER:PLAINTEXT' \
  -e KAFKA_INTER_BROKER_LISTENER_NAME='INTERNAL' \
  -e KAFKA_CONTROLLER_LISTENER_NAMES='CONTROLLER' \
  -e KAFKA_OFFSETS_TOPIC_REPLICATION_FACTOR=1 \
  -e KAFKA_TRANSACTION_STATE_LOG_REPLICATION_FACTOR=1 \
  -e KAFKA_TRANSACTION_STATE_LOG_MIN_ISR=1 \
  apache/kafka:latest


docker exec --workdir /opt/kafka/bin/ -it broker3 sh

Теперь, находясь внутри контейнера, выполните команды:

# Создаем "сырой" топик для входящих логов Trino
./kafka-topics.sh --create --topic trino-logs-raw --bootstrap-server localhost:29092 --partitions 1 --replication-factor 1

# Создаем "чистый" топик для обработанных логов
./kafka-topics.sh --create --topic trino-logs-cleaned --bootstrap-server localhost:29092 --partitions 1 --replication-factor 1

*Обратите внимание: я использую внутренний порт брокера `29092`, который узнали ранее.*

Выйдите из контейнера командой `exit`.

Шаг 2: Конфигурация Vector

На вашей локальной машине создайте структуру папок:

vector-trino-processor/
└── config/
    └── vector.toml

Поместите в файл `vector.toml` следующую конфигурацию. Это сердце нашего решения.

# vector-trino-processor/config/vector.toml

# ==================================
#          ИСТОЧНИК ДАННЫХ
# ==================================
# Читаем сырые логи из Kafka
[sources.trino_raw_logs]
  type = "kafka"
  # Подключаемся к брокеру по имени контейнера и внутреннему порту
  bootstrap_servers = "broker3:29092"
  # Указываем, какой топик слушать
  topics = ["trino-logs-raw"]
  group_id = "vector-trino-cleaner"
  # Vector автоматически распарсит входящие сообщения как JSON
  decoding.codec = "json"

# ==================================
#             ТРАНСФОРМАЦИЯ
# ==================================
# Удаляем поле `query` и служебные метаданные Vector
[transforms.clean_trino_log]
  type = "remap"
  # Получаем данные от нашего источника
  inputs = ["trino_raw_logs"]
  # Скрипт на языке Vector Remap Language (VRL)
  source = '''
  # 1. Удаляем чувствительное поле "query" из лога.
  del(.query)

  # 2. Удаляем все служебные поля, которые Vector добавляет
  #    при чтении из Kafka, чтобы на выходе был чистый JSON.
  del(.headers)
  del(.message_key)
  del(.offset)
  del(.partition)
  del(.source_type)
  del(.timestamp)
  del(.topic)
  '''

# ==================================
#           ПРИЕМНИК ДАННЫХ
# ==================================
# Пишем очищенные логи в новый топик Kafka
[sinks.trino_cleaned_logs]
  type = "kafka"
  # Принимаем на вход данные, прошедшие трансформацию
  inputs = ["clean_trino_log"]
  bootstrap_servers = "broker3:29092"
  # Указываем топик для записи
  topic = "trino-logs-cleaned"
  # Кодируем итоговое событие обратно в JSON
  encoding.codec = "json"

Шаг 3: Запуск и Тестирование

Нам понадобится три терминала.

В Терминале №1 — Запустим Vector

Перейдите в папку `vector-trino-processor` и выполните команду:

docker run \
  -d \
  --name vector-processor \
  -v "$(pwd)/config:/etc/vector/" \
  --network=my_net \
  --rm \
  timberio/vector:latest-alpine --config /etc/vector/vector.toml

Эта команда:

  • Запускает контейнер Vector в фоновом режиме (`-d`).
  • Дает ему имя `vector-processor`.
  • Монтирует ваш локальный конфиг (`-v`).
  • Подключает его к той же сети, что и Kafka (`--network`).
  • Явно указывает, какой файл конфигурации использовать (`--config`).

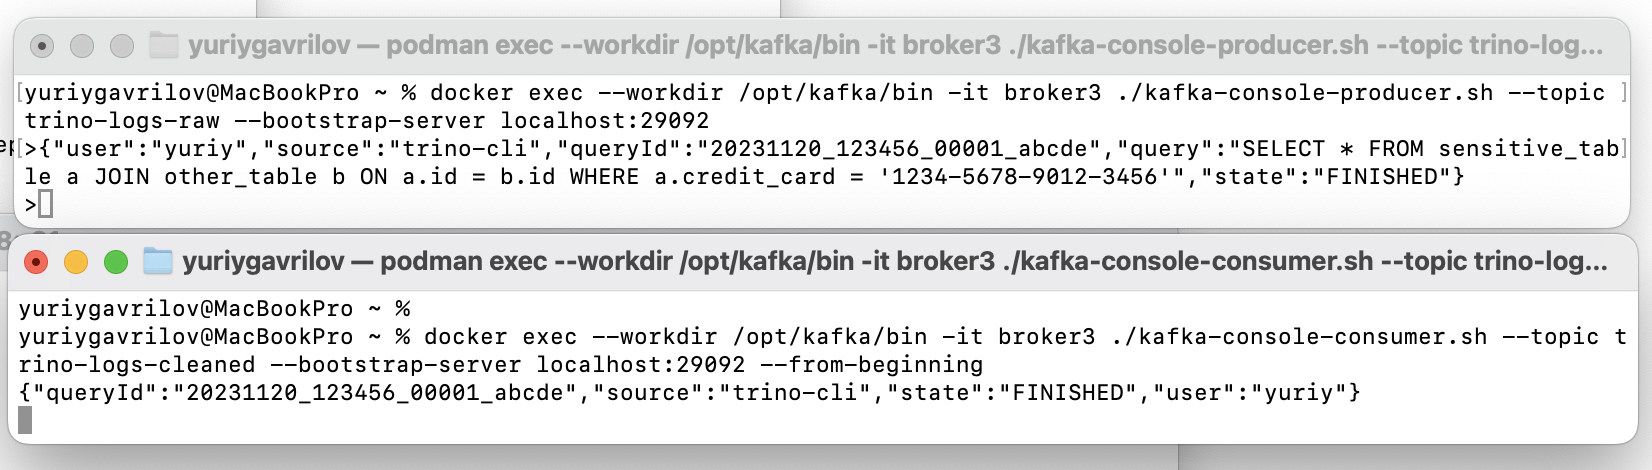
В Терминале №2 — Симулируем отправку лога Trino

Запустим интерактивный Kafka-продюсер.

docker exec --workdir /opt/kafka/bin -it broker3 ./kafka-console-producer.sh --topic trino-logs-raw --bootstrap-server localhost:29092

Теперь вставьте в этот терминал JSON, имитирующий лог от Trino, и нажмите Enter:

{"user":"yuriy","source":"trino-cli","queryId":"20231120_123456_00001_abcde","query":"SELECT * FROM sensitive_table a JOIN other_table b ON a.id = b.id WHERE a.credit_card = '1234-5678-9012-3456'","state":"FINISHED"}

В Терминале №3 — Проверяем результат

Запустим Kafka-консьюмер, который будет слушать очищенный топик `trino-logs-cleaned`.

docker exec --workdir /opt/kafka/bin -it broker3 ./kafka-console-consumer.sh --topic trino-logs-cleaned --bootstrap-server localhost:29092 --from-beginning

Вы практически мгновенно увидите результат работы Vector — тот же самый лог, но уже без поля `query`:

{"user":"yuriy","source":"trino-cli","queryId":"20231120_123456_00001_abcde","state":"FINISHED"}

Мы построили простой, но мощный конвейер для обработки данных в режиме реального времени, решив поставленную задачу с минимальными усилиями.

Earlier Ctrl + ↓